OpenRouter 10月19-25日周榜观察:中国大模型包揽前五,周调用量连续26周超过美国。
10月26日,大模型API聚合平台OpenRouter公布的最新一周(10月19日至25日)全球AI大模型调用量周榜显示:DeepSeek于10月17日更新的V4.1-Flash-1017以33.6万亿Token的单周调用量登顶全球第一,环比激增801%;其上一代V4.1 Flash以18万亿Token位居第二;全球调用量排名前五均为中国AI大模型,中国大模型在该平台的周调用量已连续26周超过美国。
导语:一份周榜改写的全球格局
按时间、主体、数据三个维度还原事件:10月26日,OpenRouter发布10月19日至25日一周的全球AI大模型调用量榜单。榜首为DeepSeek在10月17日更新的V4.1-Flash-1017,单周调用量达33.6万亿Token,环比增幅高达801%,成为近一周爆发力最强的模型,也是拉动国产模型整体增量的核心动力。
榜单第二名同样来自DeepSeek:9月10日正式上线的V4.1 Flash以18万亿Token的周调用量位居次席,环比下滑45%——新旧两代模型包揽前两名,且流量明显从旧版向新版迁移。第三至第五位分别为MiniMax M3.1 Flash(13.7万亿Token)、智谱GLM 5.3 Flash(13.2万亿Token)和腾讯Hy4 preview(8.97万亿Token),全球调用量前五全部为中国大模型。
从大盘看,上周全球AI大模型总调用量为188万亿Token,环比增长14.63%;其中中国AI大模型周调用量93.54万亿Token,环比增长18.14%;美国模型22.47万亿Token,环比增长29.44%。中国大模型在该平台的周调用量已连续26周超过美国,稳居全球首位。需要说明的是,上述数据仅统计OpenRouter聚合API渠道的调用流量,其口径边界将在后文专门辨析。
榜单拆解:OpenRouter是什么、榜单意味着什么
OpenRouter是全球性的大模型API聚合平台,聚合接入多家模型厂商,向全球开发者和企业提供统一的调用入口,其LLM排行榜按平台实际处理的Token量对模型进行实时排名。榜单统计口径为每个模型的提示词(prompt)与补全(completion)Token总和,并包含推理Token。
正因如此,这份榜单的参考意义在于:它度量的是开发者在独立第三方渠道上的真实用量,而非厂商自报的部署规模或评测跑分。对开发者生态而言,调用侧数据是"用脚投票"的直接记录;对模型厂商而言,它是商业化验证的前瞻信号。上周Top10榜单中,中国模型占据六席(前五全部为中国模型),海外阵营仅存OpenAI GPT-6 Luna(8.35万亿Token)、Anthropic Claude Opus 5.5(8.27万亿Token)和英伟达Nemotron 3 Ultra(5.85万亿Token)三席,另有小米MiMo-V2.6-Flash(6.07万亿Token)与智谱GLM 5.3(5.05万亿Token)分列第八、第十。
拉长观察窗口,格局迁移更为直观:OpenRouter每周处理的Token量已从2025年10月下旬的5.51万亿增长至2026年10月下旬的188万亿,一年间增长接近33倍;而2025年10月27日当周,该平台调用量榜首还是马斯克旗下xAI的Grok,榜单前排几乎为海外厂商。一年之内,市场整体规模扩张约33倍,流量重心则从海外模型迁移至中国模型。
此外,榜单结构本身释放出清晰信号:Flash轻量化版本已成为平台流量的绝对主力,重参数旗舰模型不再是开发者的首选;百万Token级长上下文窗口几乎成为头部新模型的标配;模型迭代周期持续压缩,一款热门模型的优势窗口期不断缩短。
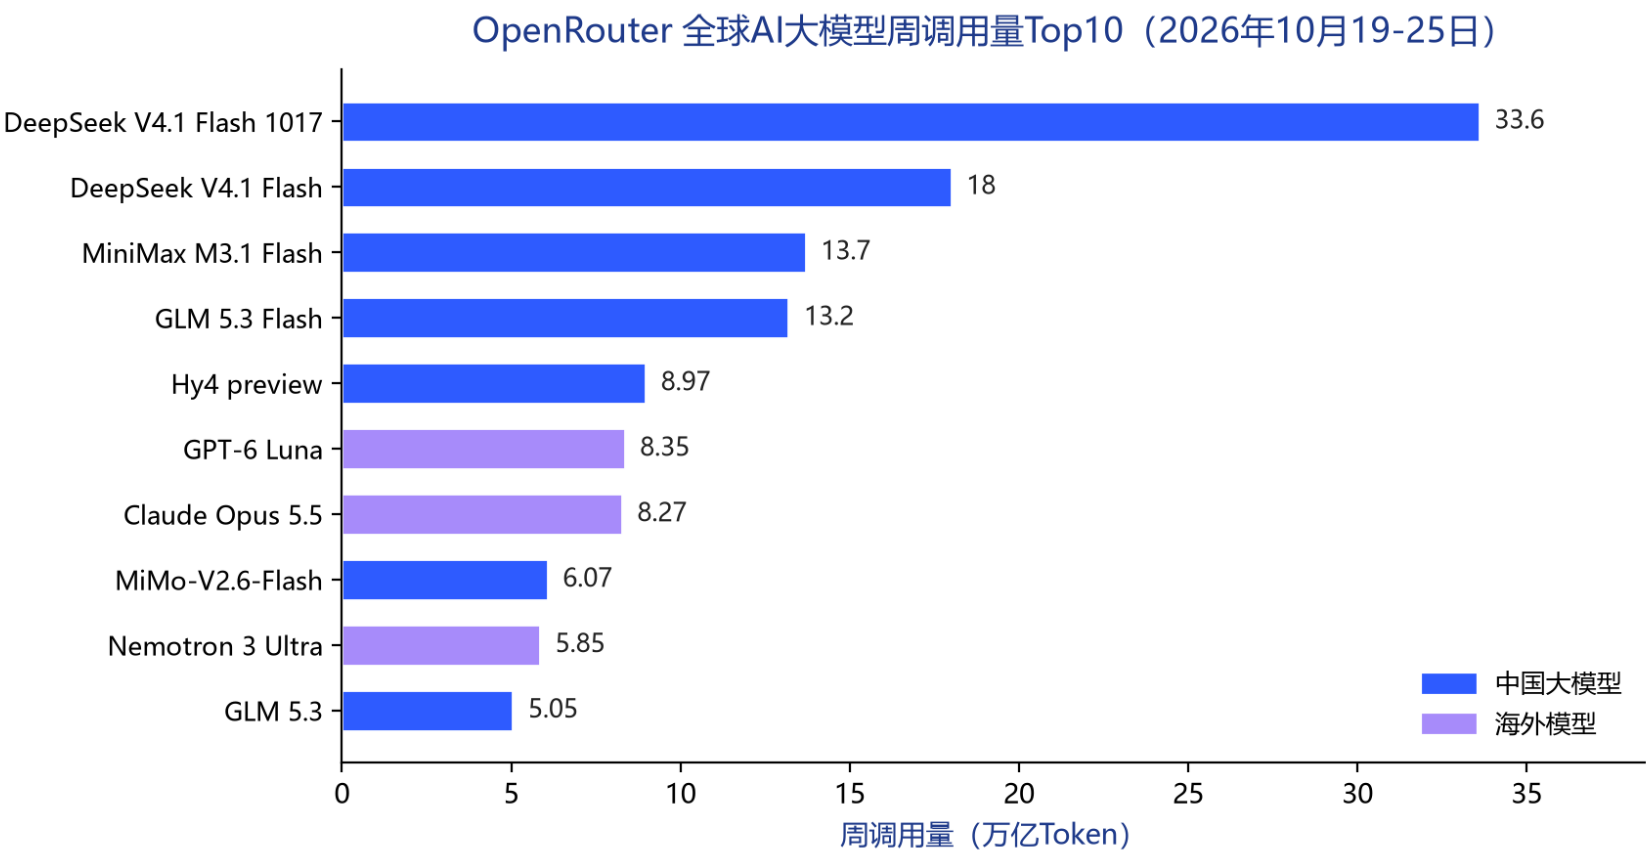
图1 OpenRouter全球AI大模型周调用量Top10(2026年10月19-25日)
环比801%:激增从何而来
单周调用量环比激增801%,意味着V4.1-Flash-1017的周调用量约为前一周的九倍。直接触发因素是版本更新本身:10月17日,DeepSeek官宣更新V4.1-Flash-1017,以9月10日发布的V4.1 Flash为基底,改善推理、编程、自动化及视觉任务表现;DeepSeek称新模型在各方面基准测试中取得长足提升,并在多个Harness(控制框架)下达到了新的性能-费用帕累托最优,即最佳性价比。
从技术规格看,该模型延续552B总参数、输入激活8B、输出激活16B的非对称MoE架构,原生支持多模态,重点优化代码、自动化Agent与视觉任务。非对称MoE的设计逻辑在于:以小规模激活参数支撑大规模总参数,在保持能力上限的同时压低单次推理成本——这正是高调用量场景所需的技术特征。
渠道与配套因素同样不可忽视。10月20日,DeepSeek宣布全面开源内部推理框架DeepInfer,并同步开源生产级词元编解码组件,目标是帮助开发者和企业优化大规模模型部署、降低AI服务的算力成本与能源消耗。开源推理底座降低了第三方渠道部署DeepSeek模型的门槛,与聚合平台渠道形成正反馈。
还需看到开发者迁移行为的放大效应:旧版V4.1 Flash周调用量环比下滑45%,与新版801%的激增形成镜像,表明开发者群体在短时间内集中向新版迁移。新版本兼容旧API、不涨价的开发者友好策略,进一步降低了迁移摩擦。将801%归因于单一因素并不严谨——版本能力提升、发布时点正好落入完整统计周、聚合渠道放量与迁移行为,四者共同构成了这次激增;其中哪些属于脉冲式尝鲜、哪些能沉淀为稳态用量,仍有待后续数周数据检验。
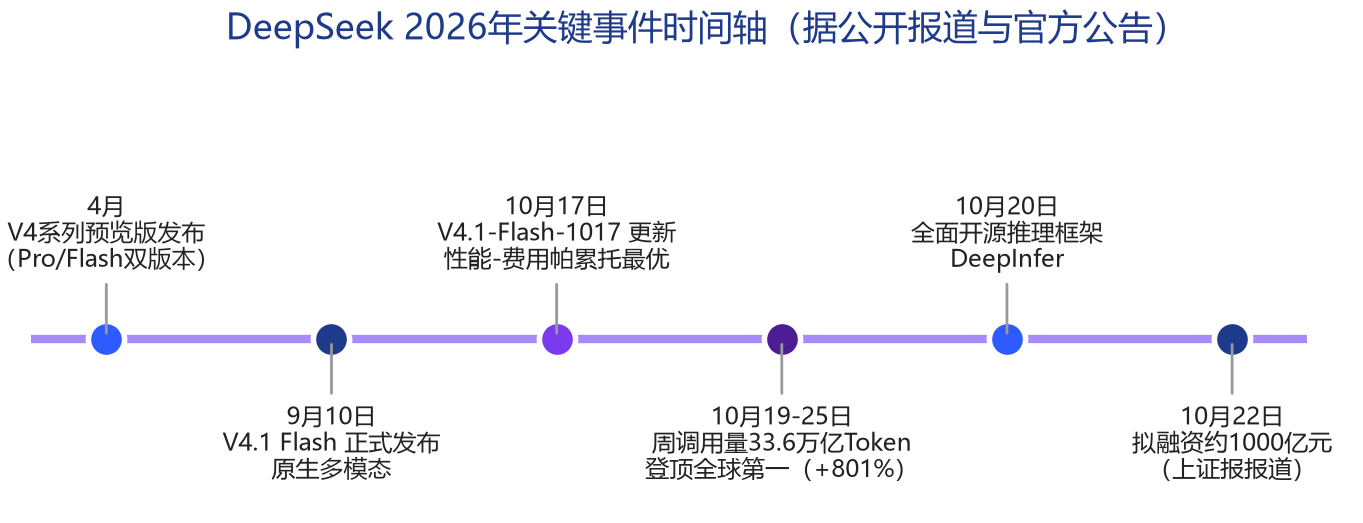
图2 DeepSeek 2026年关键事件时间轴
前五皆中国:中国大模型的调用侧领先
全球调用量前五均为中国大模型,这一结构性事实比单点登顶更具信号意义。第三名MiniMax M3.1 Flash于10月19日发布即空降榜单,官方披露其在复杂Agent任务、电脑操作、软件开发及网络安全等方面大幅提升,线上推理速度提升近3倍、使用成本降低70%;第四名智谱GLM 5.3 Flash发布于8月26日,周调用量13.2万亿Token、环比增长8%;第五名腾讯Hy4 preview已连续四周稳居第五,周调用量8.97万亿Token、环比增长19%。
从国别结构看,上周188万亿Token的大盘中,中国大模型占93.54万亿(约49.8%),美国模型占22.47万亿(约11.9%),其余模型占71.99万亿(约38.3%)。中国大模型周调用量连续26周超过美国,意味着这一领先已从偶发现象演变为周期性常态。
值得注意的是增速的错位:美国模型上周环比增速29.44%,反而高于中国模型的18.14%,但基数差距悬殊(22.47万亿对93.54万亿),增速追赶尚未改变总量格局。这一细节提示:调用侧领先并非静态优势,榜单名次的逐周易主将成为常态。
阵营化领先的结构性原因,可以从三个层面理解:其一,开源策略使中国模型可被OpenRouter等第三方平台及各类云渠道自由分发,渠道面显著大于闭源模型;其二,以非对称MoE为代表的架构创新持续压低单位推理成本,"够用能力+低价"成为标准化产品;其三,国内厂商以周为单位推送迭代版本,针对性补齐联网、代码、Agent短板,并普遍采取兼容旧API、不涨价的开发者友好策略。
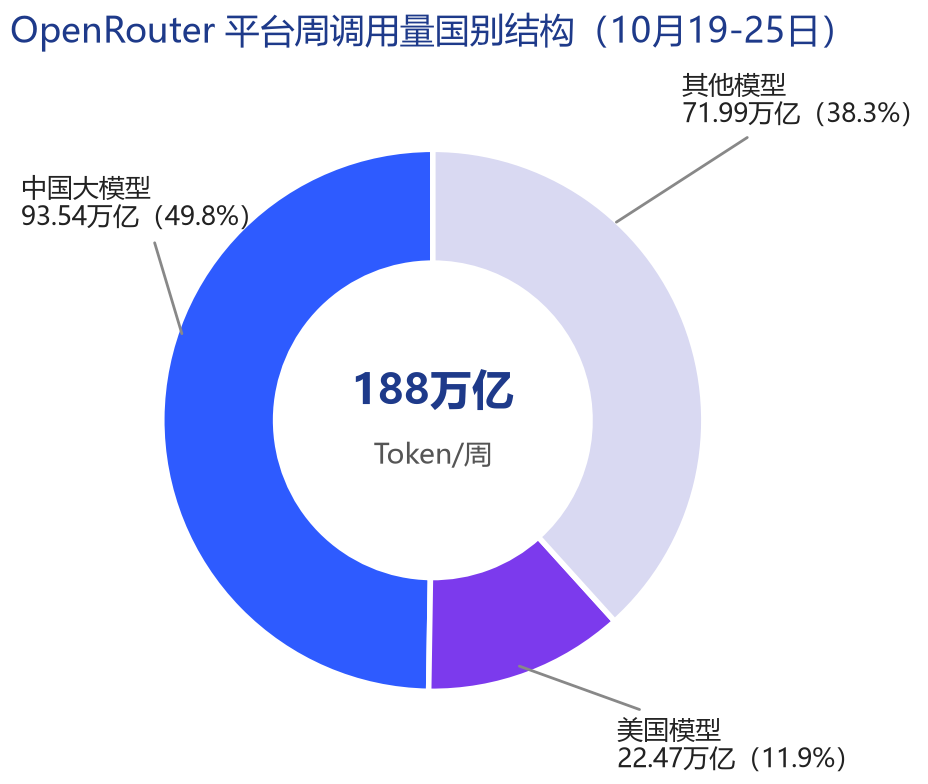
图3 OpenRouter平台周调用量国别结构(10月19-25日)
产业影响:调用侧数据对竞争格局的重构
调用侧登顶的产业影响,沿"开发者生态—推理算力—商业模式"三条路径传导。在生态层面,调用数据是开发者真实选择的结果,榜首易主直接影响新应用的技术选型与供应商组合;在算力层面,93.54万亿Token的周调用量对应可观的推理算力需求,人工智能产业发展重心已从"模型训练"全面转向"模型推理",推理效率优先正在驱动全产业链系统性重构;在商业层面,调用量是Token经济模式的基础计量,直接关联API收入。
DeepSeek自身的商业化验证同步推进。据The Information 9月24日报道(两名直接知情人士),DeepSeek年化营收运行率已突破10亿美元,较数月前增长逾一倍,收入主要来自模型API调用服务,且API提价后客户并未流失。资本层面的进展同样密集:DeepSeek拟在最新一轮融资中筹得约1000亿元人民币(约150亿美元),腾讯和宁德时代为本轮出资最多的投资方,交易预计在未来数日内正式完成;截至发稿,DeepSeek及腾讯等相关投资方均未公开回应。该公司今年6月已完成约510亿元首轮融资,投前估值约5000亿元。市场人士认为,本轮融资或为其筹备中的科创板IPO铺平道路。
但调用量第一并不等于收入第一。OpenRouter花费占比数据的分析,平台资金花费结构中通用任务占32.1%、Agent占30.9%、Code占26.7%;在准确率要求较高的分类任务上,Claude Opus 5.5以10.3%的花费份额居首,DeepSeek V4.1 Flash以2.9%位居第八、是该榜单前十中唯一的中国模型——中国模型用性价比拿下了流量入口,但能否把Token转化为收入和利润,仍取决于付费结构、推理成本与高难度任务的完成能力。海外头部模型依旧依靠稳定的复杂推理能力,守住大型企业高端闭源市场的基本盘。
由此形成当前全球赛道的双轨格局:OpenAI、Anthropic以高定价、高能力上限服务高端闭源市场;中国厂商集中资源打磨高吞吐、低成本、强多模态的Flash系列,抓住中小开发者与自动化批量任务的增量市场。行业分析普遍认为,大模型竞争已从单纯跑分竞赛,转向单位Token成本下的有效产出比拼,低价、高吞吐是撬动开发者迁移最直接的筹码。
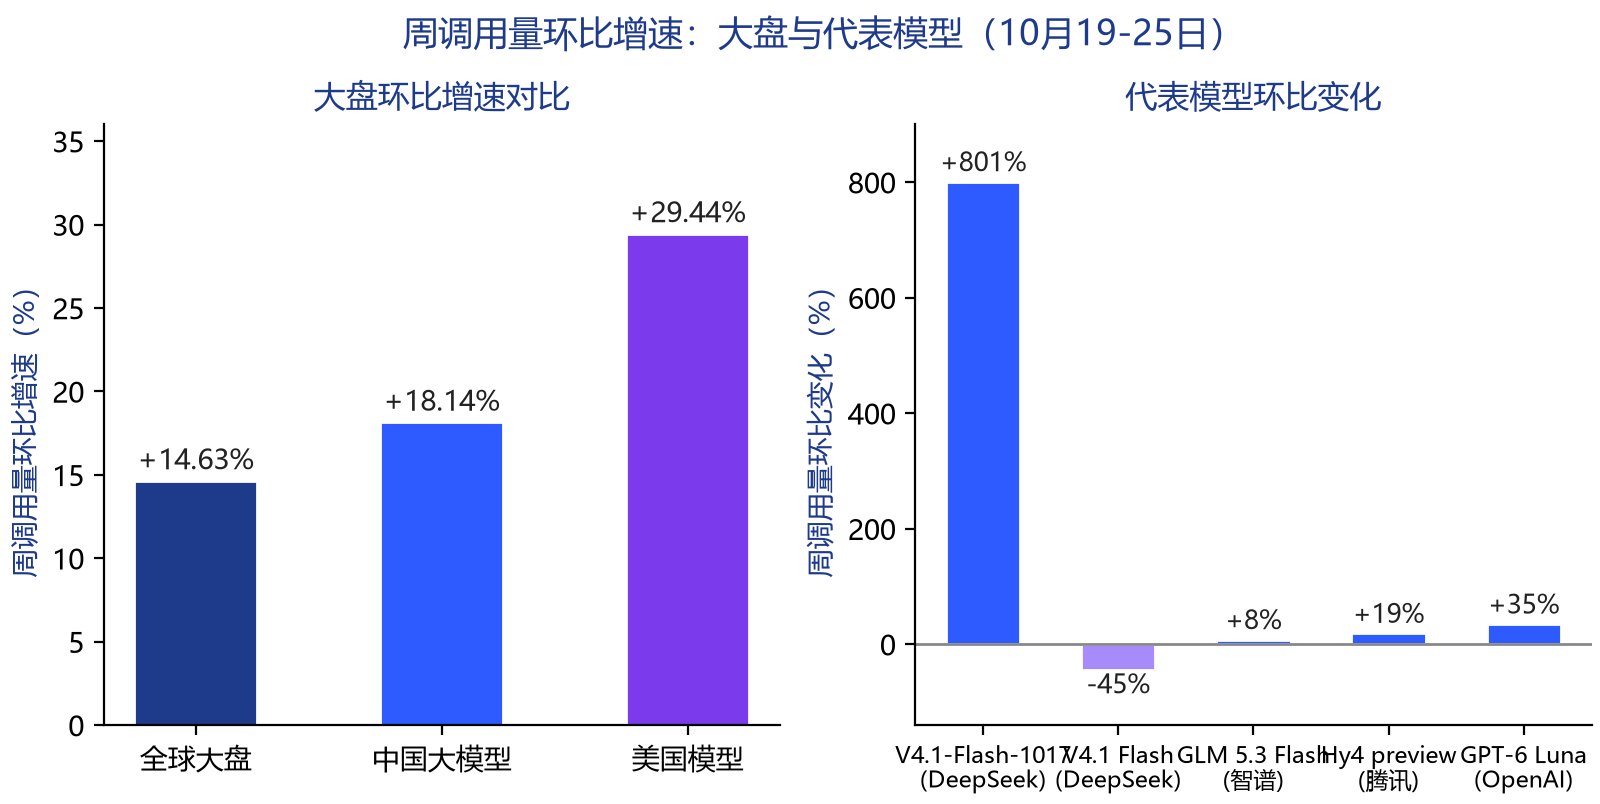
图4 周调用量环比增速对比
辩证观察:单平台数据的能力边界
对这份榜单的解读必须回到口径边界。OpenRouter的数据只统计经由该平台路由的流量,厂商自有官网与API直连、云厂商平台、私有化部署以及直接面向消费者的应用和网页产品均未纳入,因此榜单数据不能直接等同于全球市场份额。美国头部模型的分销以官网直连和云厂商绑定为主,其在OpenRouter上的占比天然低于其真实市场地位;反之,开源可分发的中国模型在聚合渠道上的曝光度相对更高。
换言之,这份榜单更宜被视作全球独立开发者和中小企业需求的直观风向标,而非全市场的份额普查。"中国大模型连续26周领先美国"的准确含义是:在第三方聚合渠道的开发者调用侧,中国模型连续26周领先——这一限定语不可省略。
具体到本周数据,也存在需要后续验证的观察点:其一,801%的环比激增包含新版本发布后的集中尝鲜效应,单周脉冲能否转化为稳态用量,需观察未来数周的留存曲线;其二,榜单名次的剧烈波动(上周排名第八的智谱GLM 5.3本周跌出前十、小米MiMo-V2.6-Flash环比下滑39%)说明周度数据噪音较大,不宜以单周名次外推长期趋势;其三,涉及融资规模、上市安排的信息均为媒体报道的市场消息,截至发稿未获公司官方确认,后续以官宣为准。
结语:从登顶一周到产业趋势的观察坐标
复盘本次事件:DeepSeek V4.1-Flash-1017以33.6万亿Token、环比801%的单周调用量登顶OpenRouter全球周榜,中国大模型包揽前五,周调用量连续26周超过美国。其背后是版本快速迭代、架构降本、开源渠道与开发者迁移行为的合力,而非单一因素的突发结果。
这一事件作为观察坐标的价值在于三点:其一,大模型竞争的评价体系正从训练侧跑分转向调用侧验证,单位Token成本下的有效产出成为核心竞争维度;其二,中国模型的差异化路线(开源、轻量、高性价比、周级迭代)已在调用侧形成阵营化优势,但花费份额与高端任务市场仍由海外模型主导,流量优势向收入优势的转化是下一阶段的关键命题;其三,榜单名次的周度起落将成为常态,单一一周的登顶不宜过度引申,持续迭代并平衡能力、速度与成本,才是厂商长期留在牌桌上的通行证。
后续观察窗口有三:V4.1-Flash-1017调用量激增的留存情况、约1000亿元融资的官宣落地与科创板IPO进展、以及各厂商Flash级新品的下一轮排位更替。本稿将OpenRouter周榜及其口径边界作为持续跟踪中国大模型调用侧竞争的基础坐标。