10月26日,南京大学团队的论文 Omni-Woodpecker(arXiv:2610.27103)位列 Hugging Face 每日热门论文榜第2位。这项工作不动模型参数、不改语言头,仅通过“冲突诊断—证据分解—表征再平衡”三阶段推理时干预,就把骨干模型 Qwen2.5-Omni-7B 在跨模态幻觉基准 CMM 上的成绩从73.2分提升到86.1分。当全模态大模型加速走向产业落地,这条“在幻觉形成的地方修正,而不是在它出现的地方补救”的表征层路线,正在成为幻觉治理的第三条技术路径。
一、榜单事实坐标:HF每日论文第2位与论文身份核验
在10月26日的 Hugging Face Daily Papers 榜单上,Omni-Woodpecker 以94个upvote位列第2位,仅次于获得186个upvote的 RSIHub(arXiv:2610.32253)。这篇全名为《Omni-Woodpecker: Hallucination Correction via Evidence-Prior Rebalancing for Omni LLMs》的论文于10月19日提交至arXiv预印本平台,编号2610.27103,属人工智能(cs.AI)方向,兼涉计算语言学、计算机视觉与多媒体。
作者团队方面,论文署名为 Zijian Liu、Chaoyou Fu(傅朝友,通讯作者)、Yan Yang、Caifeng Shan 与 Ran He:前四位来自南京大学智能科学与技术学院(苏州校区),Ran He 来自中国科学院大学。论文正文共10页,含4幅图、6张表;代码已在 GitHub 开源(github.com/ZiiJianLiu/Omni-Woodpecker)。需要说明的是,“登顶”表述应为“位列当日榜单第2位”,榜单首位为 RSIHub。
从收录情况看,论文摘要与核心数据已被 Papers with Code 收录,并被多家国内外科技媒体与论文社区转载解读,各转载源对作者、单位与核心数值的表述相互一致。
二、问题机理:幻觉不是“没看见”,而是证据被先验压制
全模态大模型(Omni LLM, OLLM)在语言模型之外统一接入视觉与音频编码器,能够对文本、图像、音频、视频进行联合推理,是当前多模态产业竞争的焦点形态。但论文指出,当不同模态提供不完整或相互冲突的线索时,模型难以在“实际感知到的证据”与“训练中学到的先验”之间取得平衡,跨模态幻觉由此产生。
论文用一组直观案例说明机理:当用户提问“狗在叫吗?”时,模型其实已从音频中编码到“安静”的证据,但“看到狗”这一强烈的视觉先验在多模态融合阶段压过了音频证据,最终模型给出与听觉输入相悖的回答。这表明全模态幻觉的根源不是证据编码失败,而是表征纠缠——证据与先验在融合过程中严重失衡。
现有缓解方法主要包括对比解码、模态自适应生成与偏好优化三类,其共同点是都在“输出层”动手:或校准最终解码分布,或优化回答偏好。论文认为,在早期融合的全模态架构中,证据与先验在解码开始前就已深度纠缠,仅调整最终答案而不控制内部表征,难以修复真正导致幻觉的隐藏状态。
三、方法拆解:诊断—分解—再平衡的三阶段免训练流水线
Omni-Woodpecker(OWP)是一个免训练(training-free)框架:不修改模型参数、不改动语言头,把幻觉缓解从输出层操作前移到表征层再平衡。整个流水线分三个阶段。
第一阶段是查询条件冲突诊断。框架让冻结模型分别运行四种输入视图——全输入、仅音频、仅视频、仅文本,通过“目标分型”判断查询真正需要的证据模态,再通过“竞争源验证”锁定与之竞争的线索来源,全程不使用任何标签或参考答案。第二阶段是证据保持冲突分解:将视图间差异转化为一个受保护的证据方向和一个与之正交的竞争先验方向,并量化证据缺口,同时定位发生冲突的注意力头;由于两方向正交,抑制先验分量不会触碰证据分量。第三阶段是冲突自适应表征再平衡:依据全视图答案偏好计算修正预算分配系数,把预算在注意力路径编辑与残差状态编辑两个干预点之间自适应分配,在解码前恢复被抑制的证据、衰减误导性先验,且仅在被判定存在冲突时触发编辑。
机制层面,消融实验显示证据增强与先验抑制两个组件互补:仅做证据增强可使幻觉回答率(HR)下降13.00分但伤害忠实度,仅做先验抑制可使HR改善27.33分;两者结合取得最优平衡。层位上,证据恢复适合中间层(12/16/20层),先验抑制适合后层(24/26/27层),层位互换会使准确率下降6.79分(p<0.001)。干预后表征的“证据-先验平衡”移动14.25分,而代表性表示编辑方法 HulluEdit 仅移动2.19分;证据主导态占比从23.0%提升到50.8%。
四、实验核验:基准数据、推理开销与消融证据
主实验以 Qwen2.5-Omni-7B 为骨干、在 CMM(1,200个跨模态冲突案例)与 AVHBench(5,302个样本)两个跨模态幻觉基准上进行。结果显示:CMM 成绩由73.2提升至86.1(+12.9分),显著超过对比解码方法 AVCD(74.8)、模态自适应方法 MAD(81.2)与表示编辑方法 HulluEdit(79.2),超最强基线4.9分(p<10^-16);AVHBench 整体成绩提升8.6分,OWP 取得整体F1 83.3,其中 Audio→Video 84.9、Video→Audio 85.3、AV Matching 81.1三个子项分别高出骨干与基线组6.6至17.9分。忠实回答率(HR)由57.0提升至85.5,与忠实前提准确率(PA)的差距由32.5分收窄至1.2分。
通用能力方面,OWP 在 OmniBench、WorldSense、MUSIC-AVQA、AVQA 四项通用全模态推理基准上稳定提升0.67至2.25分:OmniBench 由45.36升至47.29(+1.93分),WorldSense 由45.21升至47.46(+2.25分),MUSIC-AVQA 由85.08升至86.08(+1.00分),AVQA 由91.83升至92.50(+0.67分)。跨架构泛化方面,同一框架用于 VideoLLaMA2-AV,CMM 由76.2提升至80.8(+4.6分)、AVHBench 提升3.9分。一个值得注意的横向对比是:经 OWP 增强后的 Qwen2.5-Omni-7B 在 CMM 与 AVHBench 上分别超过更新的 Qwen3-Omni 模型4.3分与6.2分。
开销是免训练方法的生死线。在 RTX A6000 上,Qwen2.5-Omni-7B 骨干单次推理延迟为3.54秒(以骨干为1.00倍基准),OWP 为6.05秒(1.71倍,前向调用不超过5次),低于 MAD 的2.81倍(9.96秒)与 HulluEdit 的3.68倍(13.02秒);在 VideoLLaMA2-AV 上开销为1.77倍。得益于冲突触发调度,实际仅25.8%的输入被判定存在冲突并触发编辑,其中16.9%改变了最终答案,其余74.2%保持骨干原输出;冲突目标分型与基准定义的目标模态一致率达99.48%。
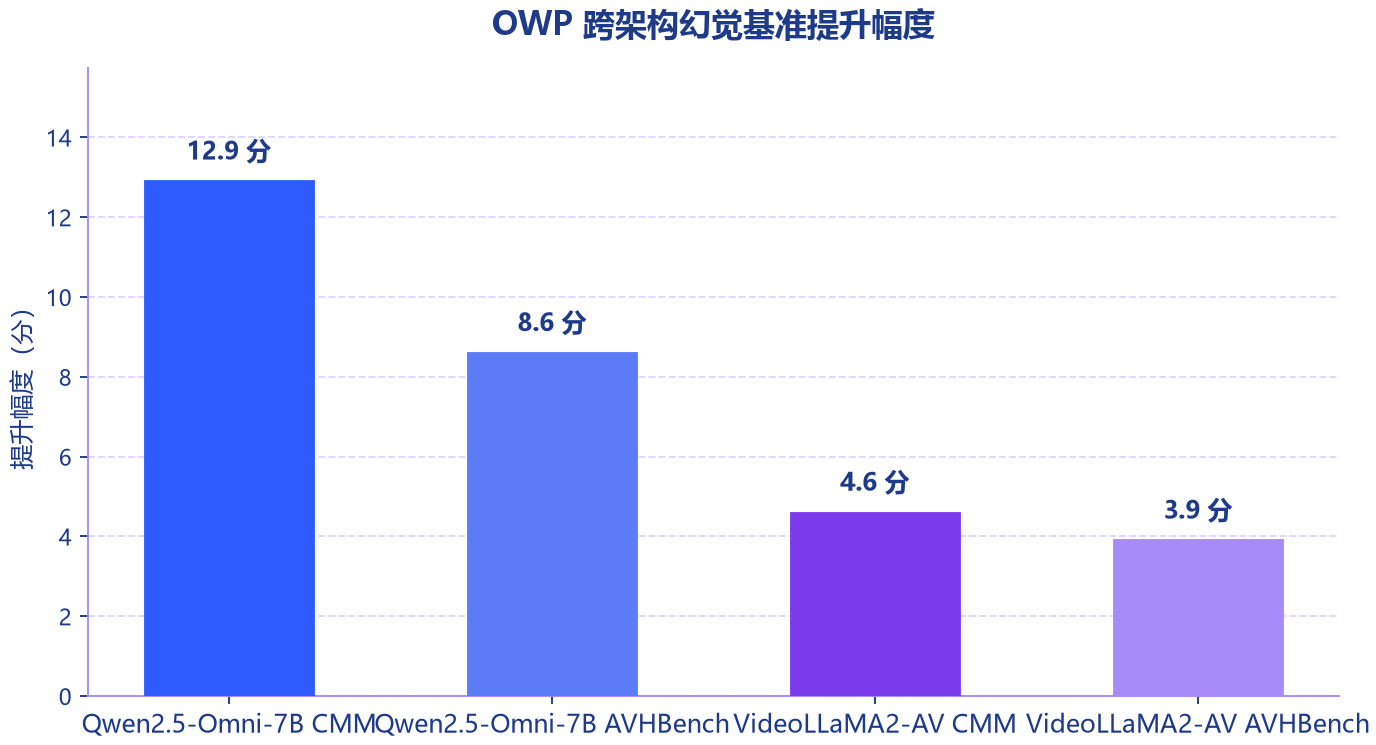
图1 OWP 跨架构幻觉基准提升幅度
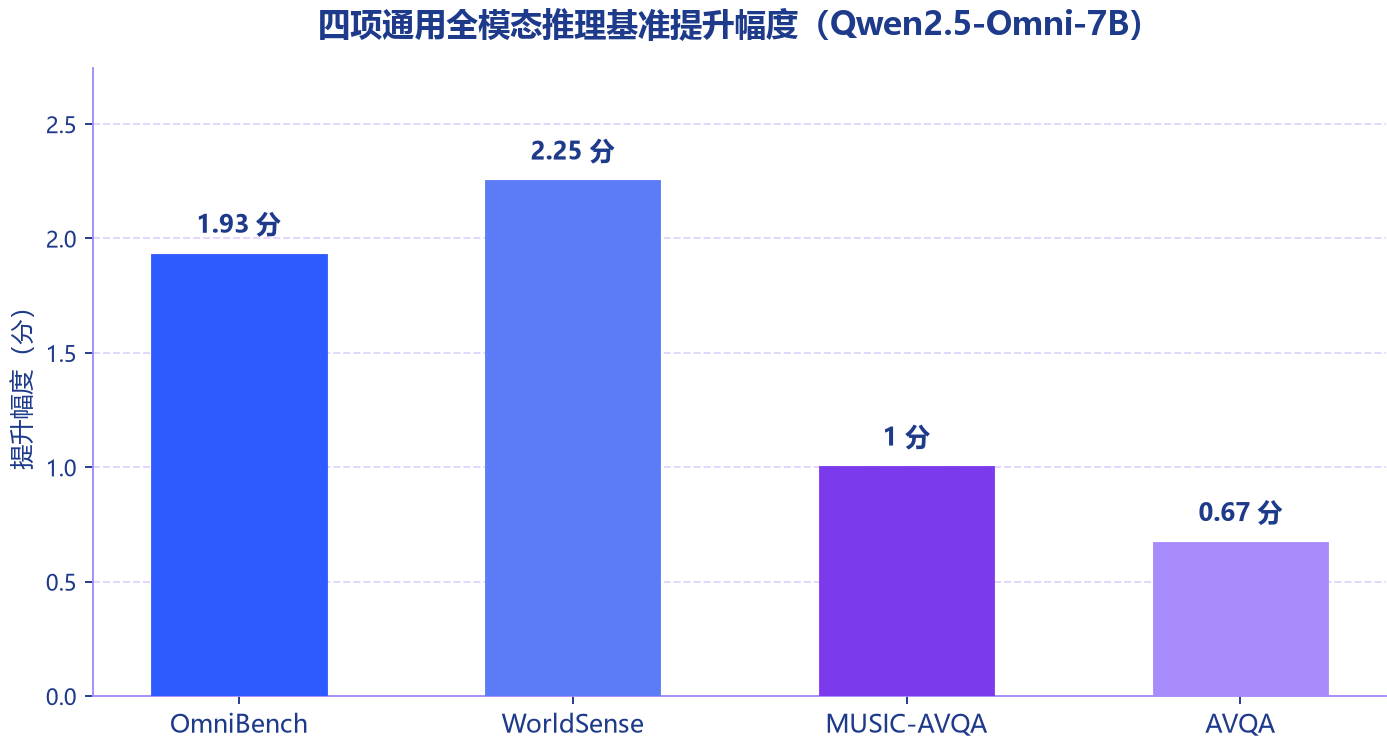
图2 四项通用全模态推理基准提升幅度(Qwen2.5-Omni-7B)
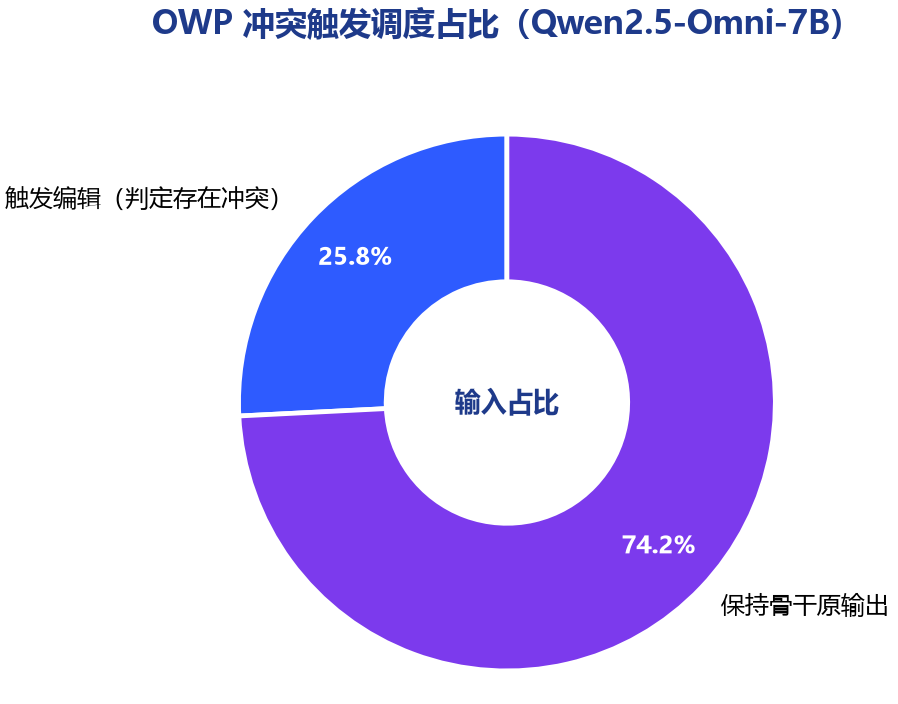
图3 OWP 冲突触发调度占比(Qwen2.5-Omni-7B)
五、渊源、局限与产业坐标:表征层干预成为第三条路线
从技术谱系看,Omni-Woodpecker 是“啄木鸟”系列的延续。2023年10月,同一研究脉络发表 Woodpecker(arXiv:2310.16045),以五阶段后处理方式为多模态大模型矫正视觉幻觉,在 POPE 基准上较 MiniGPT-4/mPLUG-Owl 分别提升30.66%/24.33%的准确率,成果发表于《中国科学:信息科学》(SCIENCE CHINA Information Sciences, 2024);Chaoyou Fu 为两代工作的共同作者。从面向图像幻觉的“文本后处理”,到面向音视频联合推理的“表征层干预”,系列工作的关注点随模型形态同步迁移。
骨干模型背景方面,Qwen2.5-Omni-7B 是阿里2025年3月发布的通义家族首个端到端全模态大模型,采用 Thinker-Talker 双核架构,统一处理文本、图像、音频与视频并实时生成文本与语音,曾取得 OmniBench SOTA,并支持手机等边缘设备部署。2026年以来,全模态赛道迭代加速,新一代全模态模型密集发布,跨模态可靠性问题随之从实验室议题上升为产业议题。
论文亦明确列出四条局限:其一,方法仅覆盖跨模态幻觉,不涉及时间性幻觉等其他类型;其二,只能恢复骨干已编码但在融合中未被使用的证据,无法补充根本缺失的感知;其三,需要访问模型内部状态,仅适用于开放权重模型,不适用于仅提供 API 的闭源模型;其四,需要额外前向传播,冲突触发调度将开销控制在1.71至1.77倍。
产业视角下,OWP 的价值在于三点:免训练意味着无需构建纠偏数据集与承担训练成本,可直接叠加在既有开源全模态模型之上;1.71倍的延迟开销与25.8%的低触发率,使其具备工程落地可行性;而其“证据-先验再平衡”的机理结论——幻觉源于表征纠缠而非感知缺失——为后续训练类与推理类方法的组合提供了明确的理论接口。对依赖开源权重模型构建音视频应用的产业生态而言,一个可插拔、可解释、跨架构泛化的表征层纠偏组件,正在把多模态可靠性从“重新训练”的重资产选项,变成“推理时介入”的轻量选项。
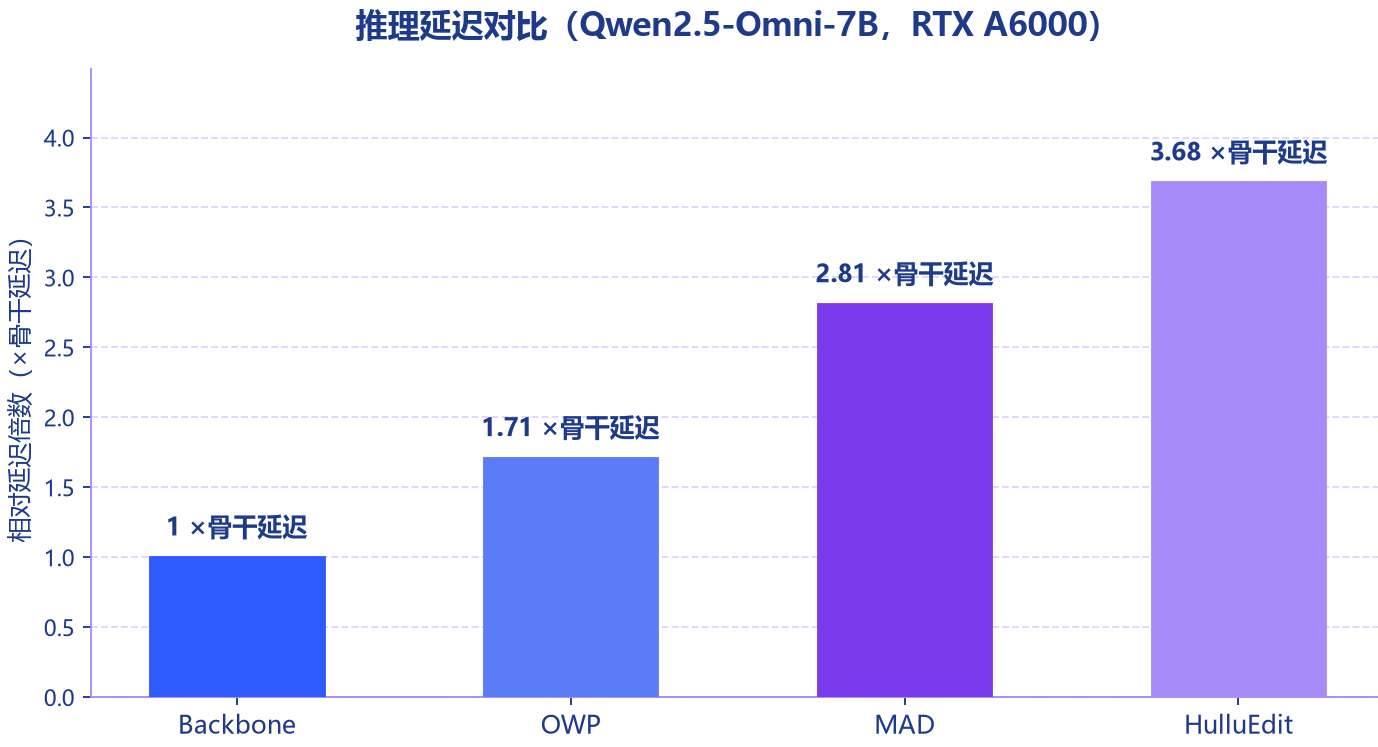
图4 推理延迟对比(Qwen2.5-Omni-7B,RTX A6000)
结论
Omni-Woodpecker 以免训练的表征层再平衡,把全模态幻觉治理从输出补救推进到冲突成因干预,在 CMM、AVHBench 及四项通用基准上取得一致增益,且开销可控、跨架构可泛化。
其对开源全模态生态的现实意义,在于把多模态可靠性变成一个可插拔的推理时组件。