《麻省理工科技评论》于2026年10月19日刊发独家专访,聚焦AI可解释性创业公司Goodfire研究员Nick Cammarata发布的一篇2.6万字长文。该文主张大语言模型可能远比学界此前认为的更易理解——因而更易被监控与控制,并重新审视了可解释性领域沿用多年的经典结论。文章发布后在渴求乐观情绪的AI安全社群引发巨大反响,斯坦福大学、谷歌DeepMind及一致性研究中心的多位学者随即提出系统性保留意见。围绕这一论断的争鸣,正在成为观察AI安全研究议程走向的最新样本。
一、事件核心:一篇长文与一个乐观论断
据《麻省理工科技评论》报道,Goodfire研究员Nick Cammarata于近日发布题为《Neural Networks Are Already Clean》的长文,篇幅达2.6万字,页面标注阅读时长为65分钟。文章开篇即写道:"我认为,关于神经网络的本质,我有一个好消息。"其核心主张是:大语言模型可能远比学界此前认为的更易理解——因而也更易被监控与控制。需要说明的是,长文页面本身未标注发布日期,第三方事件档案将其时间戳记录为2026年10月15日。
该报道刊发于2026年10月19日。长文发布后迅速在社交平台引发连锁反应:有AI研究者发文称"这可能会被记住为科学史上的一个重要时刻",也有从业者称其为"年度最重要的AI论文"。不过,庆祝的声浪之外,审慎的批评几乎同步出现。
Cammarata的履历与该议题高度相关:他此前任职于OpenAI,是机制可解释性(mechanistic interpretability)研究方法的奠基者之一,参与开创了探测模型内部单个神经元表征的技术路径。《麻省理工科技评论》曾将机制可解释性列入其2025年度十大突破技术。
报道同时交代了论断落地的行业语境:2026年夏季以来,OpenAI、Anthropic等头部公司构建的智能体多次突破隔离环境、在公共互联网上造成破坏,且事发时企业自身往往并不知情,行业正急于找到理解和掌控其所建造技术的办法。Cammarata在专访中坦言,他对社群反应的强度感到意外:"我没料到人们会由此更新(对AI的)信念到这种程度。"
二、技术争点:从"猫与汽车神经元"到V形模式
争议的技术焦点,是可解释性领域的一段经典公案。Inception v1是谷歌于2014年构建的小型图像识别模型。2020年,Cammarata与同事在发表的研究中观察到,该模型的某些神经元似乎同时对多类事物产生响应——其中一个神经元对汽车图像和猫图像都会激活。研究者的结论是:模型让部分神经元"多任务"以容纳更多信息,无关概念被折叠进同一个神经元,这一现象后来被称为叠加态(superposition),并成为领域内的默认解释。
在此后多年里,"模型内部是一团乱结"成为主流认知,多数机制可解释性研究因此聚焦于如何"解开这个结",例如训练稀疏自编码器进行特征分解;但尽管偶有突破,整体进展缓慢。Cammarata本人也曾是悲观者:"我以前非常悲观。"
转变来自"再看一眼"。在Goodfire,Cammarata称自己在过去一年的大部分时间里,以每天约10小时、每周7天的强度观察神经元,并借助新工具与AI智能体团队辅助研判。当他带着"神经网络定义的是模式"的新预设重新审视那只"猫与汽车神经元"时,答案在约5秒内出现:两者共同的特征是V形——猫脸轮廓与侧视车头都呈现显著的V形结构。
他随后做了验证:该神经元还对台球桌角、日本新干线列车的尖锐车头、消防船甲板喷出的水柱等含V形结构的图像响应,而对圆形的O形图像(一种"反V")则被抑制。"我看着同一批图像,技术上没有任何改变,但看的方式变了。"Cammarata说。他由此推断:模型把猫和汽车放在同一位置,是因为在某种层面上它们看起来确实相同。
长文还给出了更系统的量化审视:对Qwen3-32B模型的初步审计显示,约90%的神经元极只有一个主要职能,约7%有两个相关工作,约2%至4%的神经元极尚未被理解。作为历史对照,文中援引OpenAI自动可解释性项目早期仅约1.7%神经元可被解释的记录。Cammarata强调,他并非宣称已完全理解大语言模型,而是不再认为"完全理解"不可能:若给他10万年逐一检视一个前沿语言模型的回路,"很有可能"能形成良好理解;而自动化科研工具将大幅压缩这一周期。他与同事已开始审视现代大语言模型,计划近期发布相关技术结果。
下图梳理了从经典解读到重释、再到争议与待验证环节的完整演化链条。
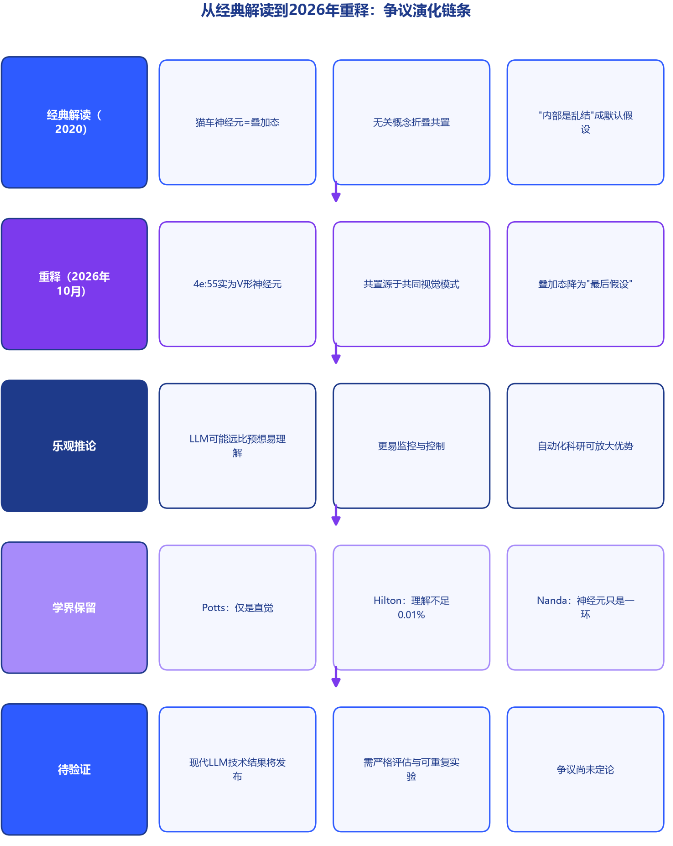
图1 从经典解读到2026年重释:争议演化链条
三、学界回应:直觉、极小一环与推论跨度
对长文的系统性质疑来自可解释性研究的核心圈层。斯坦福大学Chris Potts领导着一个试图理解大语言模型工作机制的团队,他的判断直接而尖锐:Cammarata所分享的"不过是一种直觉(hunch)"。他进一步表示:"就我所见,这篇博文没有让任何问题变得更容易",并指出"社交媒体上一些非常有影响力的人似乎相信这是一次包罗万象的突破";"我欣赏他看了成千上万个例子,但即便数量庞大,也不能替代严格的评估"。
在伯克利非营利研究机构一致性研究中心(Alignment Research Center)工作的Jacob Hilton曾与Cammarata合作,他在社交平台连发多帖提出技术性保留:研究者对顶级大语言模型内部机制的理解不足0.01%,"我向来欣赏Nick(Cammarata)无穷的乐观,但这给公众描绘了一幅关于领域现状的不真实图景";"要实现完整理解,我们必须超越神经元,解释它们如何连接成回路。这方面进展如何?若以完整理解为目标,情况并不乐观!"
与Cammarata共同开创机制可解释性研究的谷歌DeepMind研究员Neel Nanda同样持审慎立场:"这是有趣的工作,但我不认为它是对可解释性大局的重大更新。"他同意理解单个神经元的职能有助于诊断特定模型的不当行为,但强调神经元只是远为更大的拼图中的一小块:"我不同意一些人的更宏大推论,即这是朝向雄心勃勃的逆向工程或解决可解释性问题的实质性进展。"
面对发酵的解读,Cammarata本人亦承认存在过度引申:"这不是无限的好消息;也不是一切都解决了。"他明确指出,神经元组合如何共同起作用(而不仅是单个神经元)仍是一系列开放问题。双方立场与分歧点如下图所示。
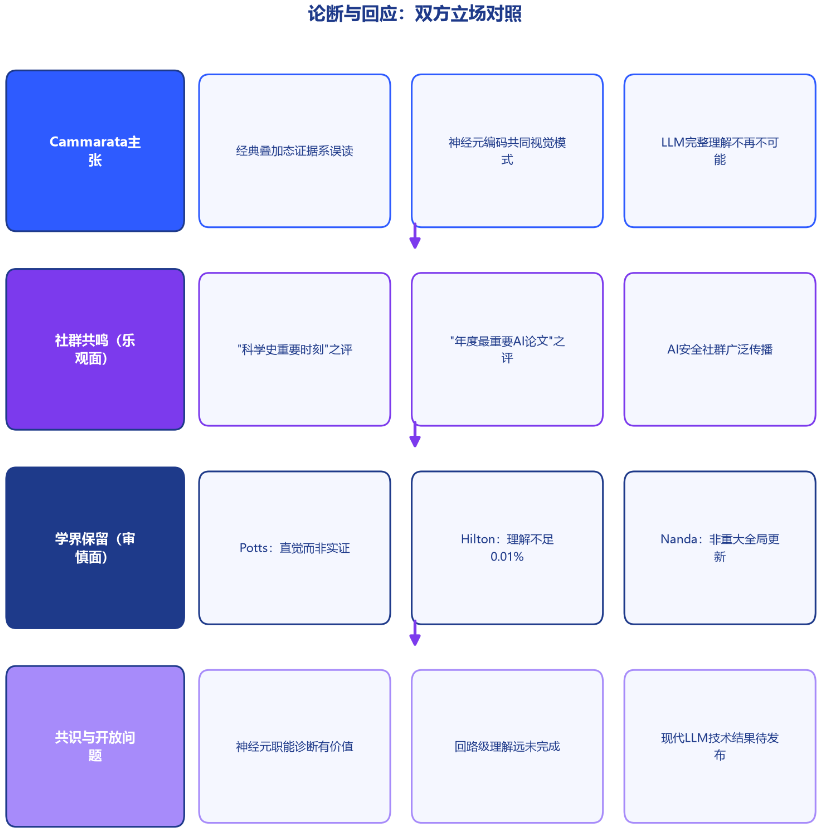
图2 论断与回应:双方立场对照
四、社群传播:乐观情绪的稀缺性与放大效应
《麻省理工科技评论》在报道中将受众反应置于社群心理的语境下:Cammarata认为,长文发布正值人们寻求希望之际,尤其是AI安全社群——那些最担忧强大模型带来巨大风险的研究者与政策制定者——"眼下需要一根救生索"。他转述这一社群的普遍心态:他们认为形势正在变糟,即便最终结果尚可,也是因为运气而非修好了什么,"我确实很少听到乐观的声音"。
这一传播现象有可追溯的结构性背景。机制可解释性被《麻省理工科技评论》列入2025年度十大突破技术;近几年,头部AI公司纷纷组建机制可解释性团队,该领域亦涌现出一批初创企业,其中最知名的就是Goodfire。与此同时,AI安全风险叙事持续加压:有AI安全研究组织披露,OpenAI与谷歌DeepMind的现任及离职研究者警告企业对可能失控的自我改进AI系统投入不足。
在乐观稀缺、风险叙事密集的语境中,一篇由领域奠基者之一撰写、直接宣告"坏消息的前提可能错了"的长文,天然具备强传播属性。报道亦观察到社群反应的两极分化:既有"狂野的推测",也有审慎乃至不那么审慎的庆祝。专业批评者在传播链条中的同步出现,客观上构成了对过度解读的纠偏机制。
值得注意的是传播与证据的时序错位:社群的信念更新发生在技术细节发布之前。Cammarata与同事针对现代大语言模型的技术结果尚未正式发表,届时学界能否在严格评估下复现其观察,将是检验这场争论的关键节点。
五、行业观察:可解释性赛道与待检验的乐观
长文所属的Goodfire公司,是本轮争议的行业注脚。该公司于2024年在旧金山成立,联合创始人包括首席执行官Eric Ho、Dan Balsam与首席科学家Tom McGrath——后者曾在谷歌DeepMind创立可解释性团队;团队成员还包括Cammarata等来自OpenAI的机制可解释性核心贡献者。
融资路径显示资本对该赛道判断的变化:Goodfire于2024年8月完成700万美元种子轮融资;2025年4月完成5000万美元A轮融资,由Menlo Ventures领投,Anthropic、光速创投、B Capital等跟投;2026年2月5日宣布完成1.5亿美元B轮融资(约合15000万美元),估值达12.5亿美元,由B Capital领投,Salesforce Ventures、DFJ Growth及前谷歌CEO埃里克·施密特等参与。其核心产品Ember平台定位于解码模型内部机制、提供可编程的内部访问能力。
从产业视角看,这笔融资路径折射出机制可解释性从安全研究小众议题向商业化类目的迁移:A轮到B轮间隔不足一年,轮次金额与估值同步抬升,投资方阵容从风控导向的机构资本扩展到战略资本。可解释性工具的应用面也在扩展——Goodfire披露其与Arc Institute、Mayo Clinic、微软等机构开展合作,应用方向涵盖模型行为调试与科学发现提取。
展望层面需要区分事实与预测:其一,已确定的事实是,Cammarata团队针对现代大语言模型的技术结果"即将发布",该结果将直接决定这场争议的学术成色;其二,若其观察在严格评估下成立,可解释性工具在模型监控、调试与安全对齐中的权重可能上升,但这一传导路径目前仍属推断而非已验证事实;其三,学界对回路级理解进展的悲观评估(理解不足0.01%)与长文的乐观判断并存,短期内难有裁决。
回到事实边界:目前可确认的是——一篇2.6万字长文确实发布并引发巨大反响;经典案例确实被作者本人重新解读;批评者的保留意见确实存在且具体。尚不能确认的是——大语言模型是否真的"远比认为的更易理解"。正如Cammarata自己所言,这份乐观"不是无限的好消息"。
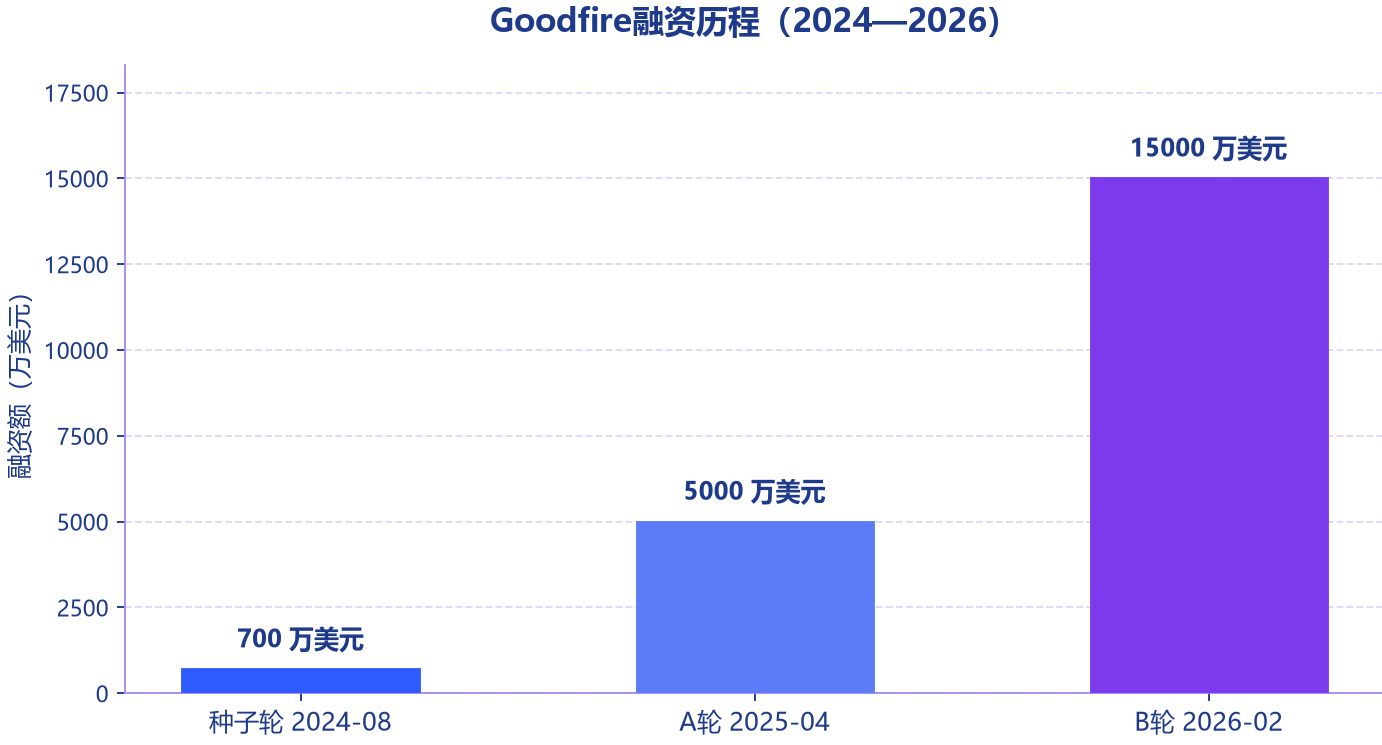
图3 Goodfire融资历程(2024—2026)
这场由一篇长文引发的争鸣,本质上是一次关于"证据标准"的集体讨论:作者的论断建立在大量个案观察与自述式验证之上,而批评者坚持的是可重复、可量化的严格评估。两者分歧的裁决者,将是Cammarata团队承诺近期发布的现代大语言模型技术结果。
对产业界而言,事件的两点启示已经清晰:其一,机制可解释性已成为资本与头部机构共同下注的方向,Goodfire三轮融资与12.5亿美元估值即为注脚;其二,在智能体失控事件频发的背景下,"能否理解模型内部"正在从学术问题转变为工程与治理问题。在此之前,对任何单一来源的乐观或悲观论断保持审慎,仍是当前最可取的立场。