10月19日上午,深圳,RISC-V中国峰会开幕式。达摩院首席科学家孟建熠就《从稳定可靠到创新卓越——玄铁IP的技术创新与开放生态之路》主题作主旨分享。这是个耐人寻味的题目:八个月前,玄铁C950以3.2GHz主频、SPECint2006突破70分刷新全球RISC-V性能纪录,行业讨论的还是“它能不能快”;今天,孟建熠没再讲那些亮眼的数据,而是讲多核、AI workload、车规,和开源社区里一个又一个patch。
“可用和量产,是两个完全不同的阶段。”孟建熠对集微网表示,可用是能演示,量产是客户敢把芯片装进自己的产品。而当性能跨过门槛之后,RISC-V要回答一个更难的问题,谁来规模化地用它?
刷新纪录、换考题,C950“聚沙成塔”
据Omdia预测,RISC-V处理器出货量年增约50%,到2030年全球每四颗处理器中可能有一颗是RISC-V。峰会上的“2026高性能里程碑”清单也在变长:英伟达GB10用RISC-V核做管理控制器,Ubuntu等主流发行版持续加码。高性能RISC-V正从宣言变成“日程表”。
性能只是一方面,RSIC-V更难的是在其他地方。玄铁团队算过一笔账:一颗处理器从立项到交付,核的研发只占两成,剩下八成都在核之外:操作系统跑不跑得起来,整机厂愿不愿意用,客户出了问题找谁。行业从不缺样品,缺的是把样品变成可量产、可交付、客户敢用的东西。这中间隔着可靠性验证、一致性保证、工具链成熟度、长期维护能力一整套工程问题,没有一项能靠把跑分再抬高五分解决。行业里那句“千呼万唤始出来”说的就是现状:能对标主流方案、价格还有优势的RISC-V应用处理器,数量依然不够多。
把时间轴拉长会更清楚。2019年C910主频首破2GHz,第一次证明RISC-V不存在天然的性能天花板;2022年的无剑600平台与曳影1520,则是玄铁第一次系统性地去处理“核之外”的事——也正是这颗芯片,让RISC-V第一次兼容安卓、第一次稳定运行笔记本电脑。八年间60亿颗出货,是这条路径一点点攒出来的,不是一次发布会攒出来的。
这也是C950刷新纪录之后,达摩院掉头去补那“八成”功课的原因。需要说明C950的位置:主频3.2GHz、单核SPECint2006突破70分,是RISC-V第一次站上主流服务器CPU的同一水位;上一代C930以15分/GHz的通用算力首次迈过服务器门槛。这半年,C950持续优化:
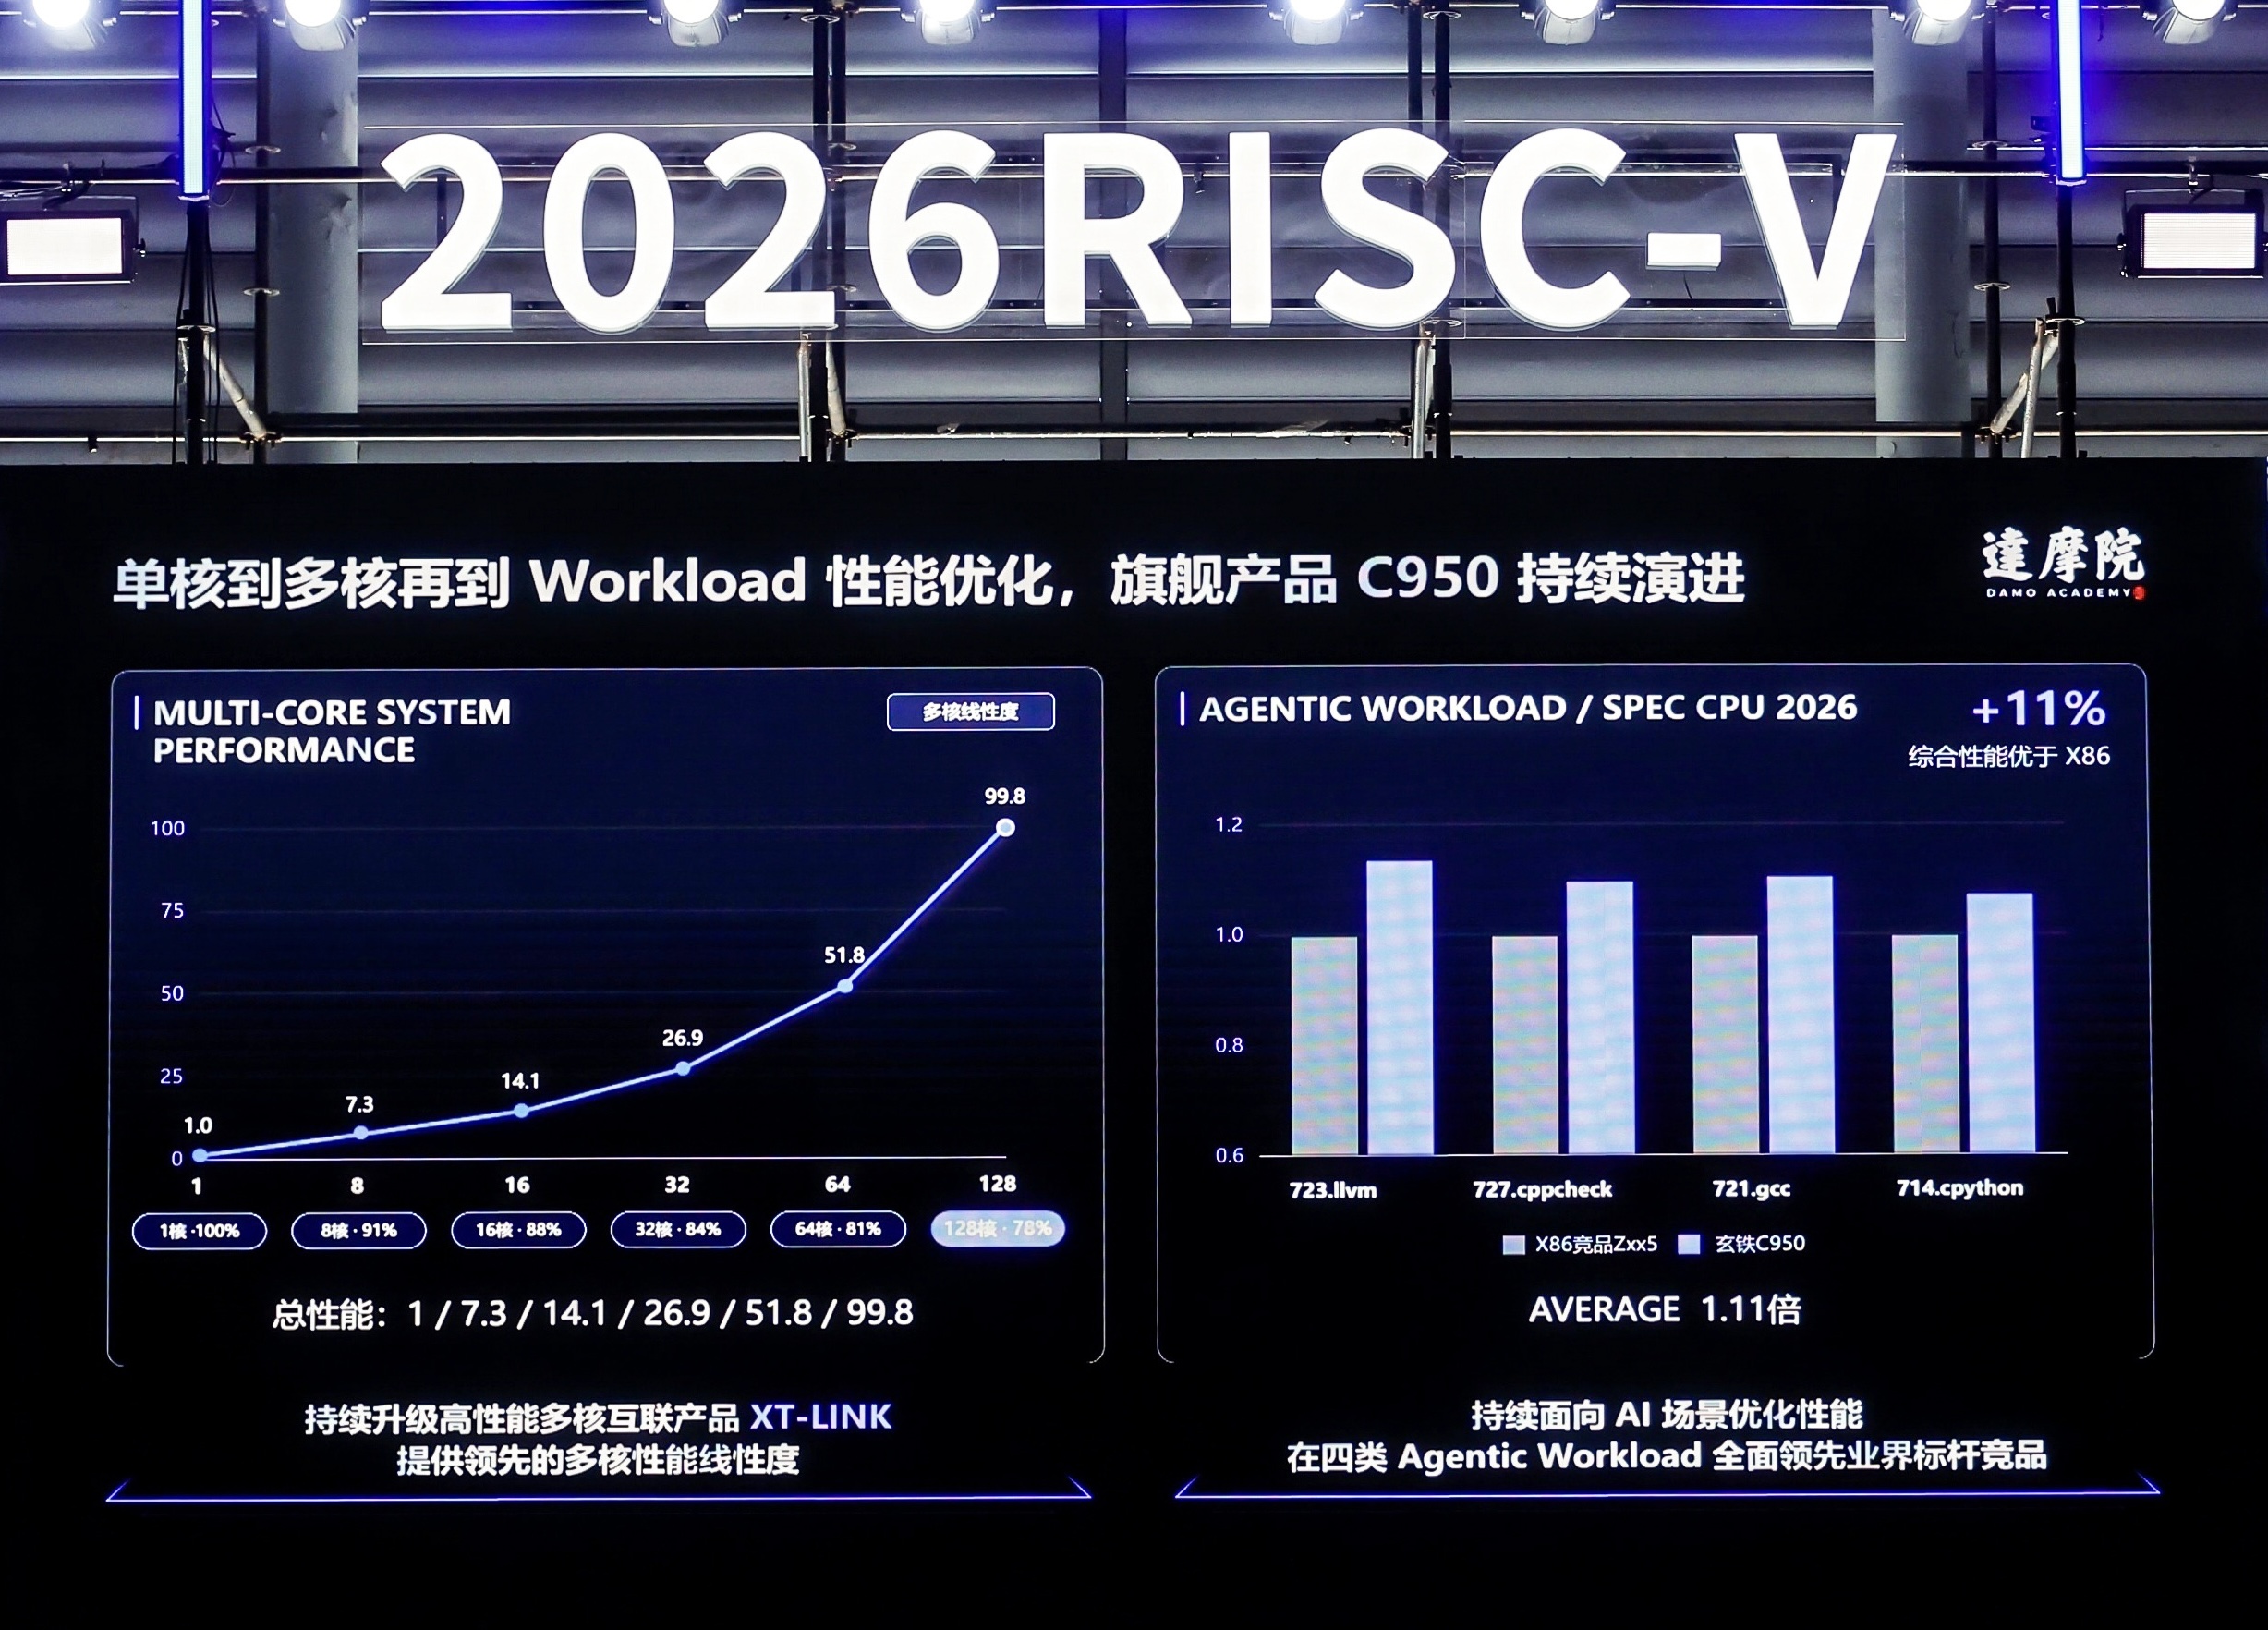
一是从单核高性能走向多核高性能。多核的难点在互联与一致性,孟建熠比喻说:单核100分,100个核理论上该到10000,实际只跑出7000,线性度就是70%。自研互联产品XT-LINK把线性度推到128核78%,128核总性能达99.8倍。
二是面向Agentic负载做优化。通用计算、矩阵加速、内存带宽与软件协同一体化之后,C950在四类Agentic负载上较主流架构平均领先约1.11倍,综合AI性能提升10%以上;跑Qwen3.8-Flash-Next达到43 token/秒,DeepSeek V4-Flash达到38 token/秒。
这里需要留意:RISC-V做推理的优势不在堆集群,而在“通推一体”。Agentic任务先跑一段通用负载、再交给AI、再返回处理,把两者放进同一颗处理器,延迟更低、成本更优,还能本地部署;超大模型的集群式计算仍是GPU的地盘。30B以下模型与Agent协同,才是C950这类“通用核+AI扩展”最清晰的位置。
向物理AI要“新战场”,玄铁路线图
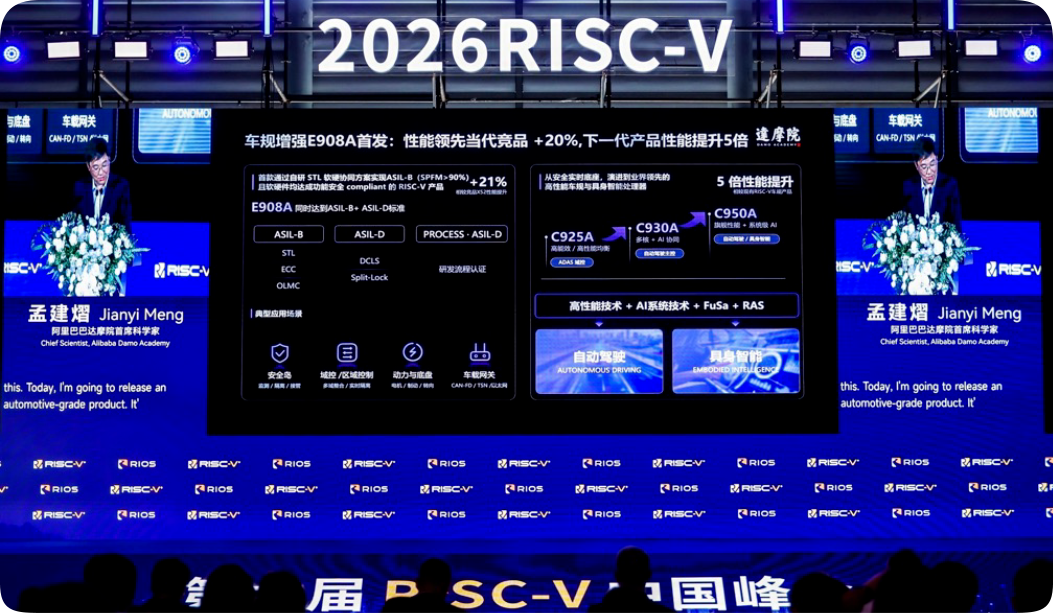
服务器与Agentic AI是正面战场,车规和具身智能是新战线。峰会上发布的E908A,是首款同时达到ASIL-B和ASIL-D的RISC-V CPU,单点安全度量(SPFM)在业内首次超过90%,性能较当代同类竞品领先约20%,面向安全岛、域控、车载网关。
孟建熠说,车规的门槛从来不只是一颗核。它有一整套软硬件研发与验证体系,产品要过流程认证,还要在十几种车型、十几年的生命周期里保持一致性。ASIL-D靠硬件冗余解决可靠性,成本高;ASIL-B靠软件手段解决,成本低,但同样要证明可靠。两条同时满足,客户才能在安全等级和物料成本之间做取舍,这也是E908A“适用面广”的真正含义。
玄铁进车规并非行业首个,孟建熠的说法很坦率:“希望带来两点增量,一是把可靠性指标做到比别人更高,二是把车规产品的性能推到前所未有的高度。”换句话说,车规卖的从来不是一颗核,而是可追溯、可复现的确定性。
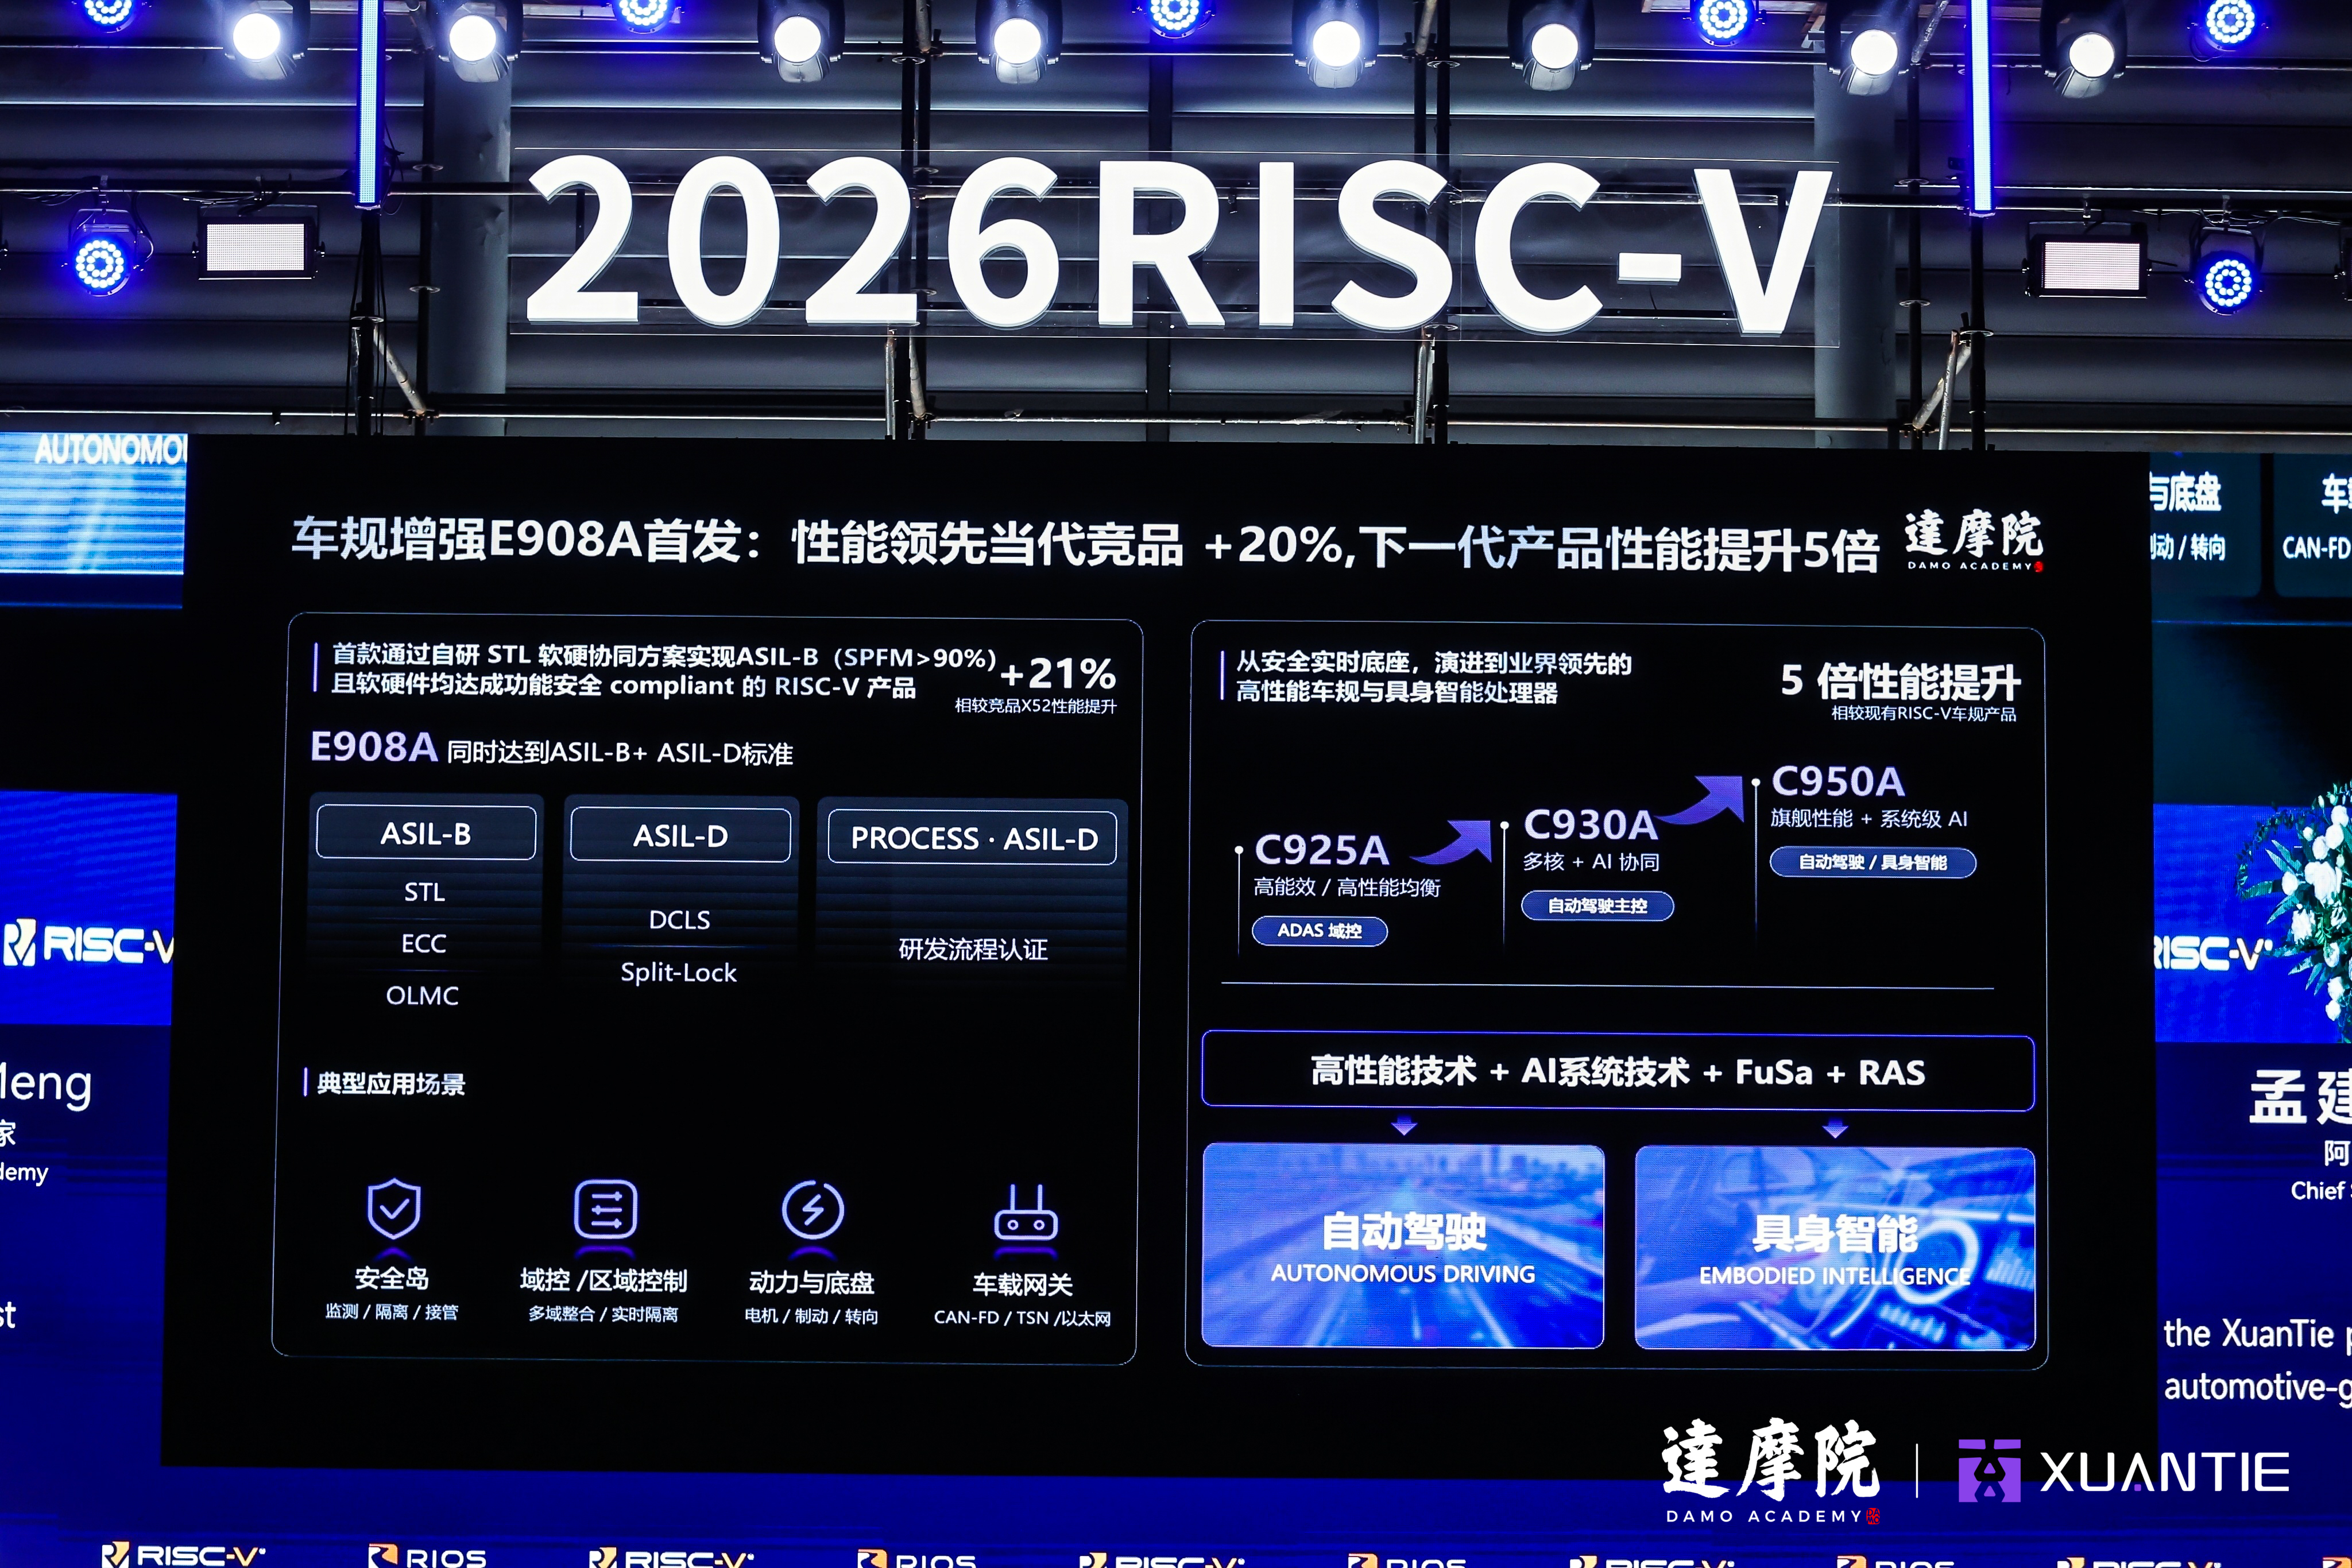
玄铁此次还公布了车规处理器路线图:C925A、C930A逐级向上,下一代C950A的性能目标为现有RISC-V车规产品的5倍,计划明年年底推出,直指自动驾驶主控,其性能与C950同级,做的是车规化改造。“要让RISC-V领域也有像英伟达那样的产品。”
为什么押注物理AI?孟建熠的判断是,Physical AI对算力与实时性要求更高,今天的通用架构不够,必须扩展,而RISC-V的可定制性正好留出空间。机器人“小脑”的实时控制已被证明可行,“大脑”的高性能计算还有更大余地——而后者恰恰需要算力与可靠性同时到位,是更难也更有价值的一段。玄铁瞄准了自动驾驶,因为它最吃算力,而算力恰是RISC-V的长项。
生态是暗线,更是一条主线
演讲里还列了一份开源清单:GCC社区的RISC-V贡献量全球第二,为处理器带来10%以上典型性能提升;OpenJDK过半数的RISC-V代码来自达摩院,C950首次实现RISC-V与服务器Java的深度适配,性能提升30%;RVI CSC认证基线建设开源2796个测试用例;作为RISE创始成员中唯一的中国企业,推动端侧适配并捐出开发板。
商业软件这关更硬:眼下RISC-V设备上能跑的多是开源软件,达摩院正推动淘宝、钉钉、微信、WPS等大型应用逐步兼容。
往前看,与北京开源芯片研究院、中兴微合作的SMT已实现双线程收益近30%;共同把AME指令集扩展推进到v0.6;与10所高校的课程共建、平台共创也在同步推进。人才是另一道坎:既懂指令集、又懂工程落地的复合型工程师,行业里一直紧缺,这类合作真正的用意也在这里。
这份清单也意味着,中国企业角色正在发生变化。过去的指令集竞争,中国公司基本是规则接受者;RISC-V的规则还在形成,谁贡献得实,谁就有发言权。AME意味着中国团队主导把真实场景的技术需求写进国际标准。
不过,RISC-V的阶段性碎片化风险真实存在——ISA组合、软件平台、交付链路的选择空间一旦失控,成本最终会被推给软件和客户。生态不是一家公司写代码写出来的,而是全行业把混乱收敛成秩序。差距也实打实:OpenEuler上x86和Arm的软件包三万多,RISC-V不足三千。目前RISC-V行业不仅在通过二进制翻译让存量软件先跑起来,还积极利用AI把迁移成本降下来。
写在最后
会场另一侧,达摩院展台是这场演讲的“实体版”:累计超过60亿颗出货、200多款量产芯片、400余家客户,构成展台最醒目的底色。展台上的动线也暗合达摩院的逻辑:芯片、平台、生态三段依次排开,恰好对应“核占两成、核外八成”。C950跑大模型的推理演示、E908A车规方案、从曳影1520延伸下来的开发板与整机,演讲结束后,达摩院展台的过道被与会嘉宾站满,行业的好奇心,已经从“它行不行”变成“它怎么落地”。
回到最初的问题:RISC-V离主流计算市场还有多远?孟建熠的答案是“三年”。他认为,两个变量在同时起作用:
一是需求侧的窗口。Agent时代的应用没有界面,只有工作负载和API调用,对传统桌面生态的依赖大幅下降;叠加x86、Arm供应紧张,东风确实在吹。但他特意补了一句:供应链只是东风,核心是应用形态变了,机会属于准备好产品的团队。
二是供给侧的耐心。一颗高性能CPU从立项到量产三年是常态,从量产到规模上量还要两三年,这中间的投入没有收入。英伟达在CUDA上投入多年才等到AI时代,RISC-V的路只会更长。3月的发布,在孟建熠看来只是拿到“150公斤级比赛的入场券”,之后要一场一场把比赛打下来。客户不为情怀买单,只认数据库拿不拿得下、出了问题有没有人管。
这也是他做了二十多年CPU最深的一个体会:交付比表态重要,产品比指标实在。一颗处理器的价值,不取决于它本身多强,而取决于有多少人在它上面做出了东西。
玄铁不再满足于做性能标杆,而要交一份“量产答案”,用60亿颗出货证明路走得通,用XT-LINK、E908A、Dragonwell和2796个测试用例,把“能用”一寸一寸改成“敢用”。处理器从来不是造出来就算成功,是用起来才算数。