10月14日,后摩智能在京主办“2026大模型赋能智能终端创新实践大会暨后摩智能生态合作伙伴大会”。来自芯片设计、大模型研发、终端制造、操作系统与行业应用等产业链代表,围绕端侧人工智能的技术路径、产品落地与生态协同展开交流。会议释放出的产业信号显示,端侧AI正从技术验证阶段走向规模化落地阶段,而以存算一体为代表的新型计算架构,正在成为支撑端侧大模型运行的算力底座。
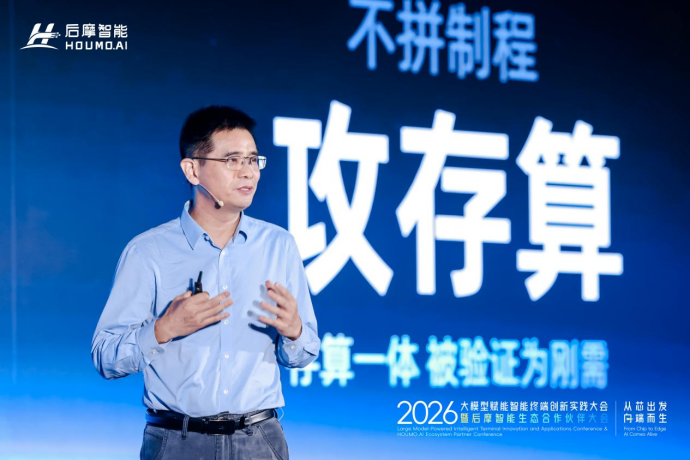
据后摩智能产品团队介绍,过去两年多时间里模型智能的密度不断提升,使得百亿级参数模型即可覆盖多数应用场景。这为大模型在终端设备上部署扫清了模型层面的障碍。与此同时,端侧AI芯片的能力边界也在快速拓宽。数据显示,仅两年时间,端侧芯片可支持运行的模型参数规模已从7B级别提升至120B级别,推理性能实现数量级增长。
在此过程中,以存算一体为代表的新型架构技术成熟度也在不断改进,提升算力的同时降低运行功耗。目前存算一体技术已完成从实验室概念到规模化量产的跨越,相关旗舰芯片量产不到一年即拿下超150个端侧产品定点,覆盖智能办公、信创终端、边缘计算、智能家居等多元应用场景,成为支撑端侧AI落地的重要算力方案之一。
后摩智能的核心技术为SRAM-CIM(静态随机存取存储器-存算一体)计算架构。该架构通过在存储单元内直接完成计算,减少数据在存储与计算单元之间的搬运,从而压缩芯片核心计算阵列面积、降低运行功耗。公开资料显示,该架构可将芯片核心计算阵列面积压缩至传统架构的三分之一,功耗降至十分之一。
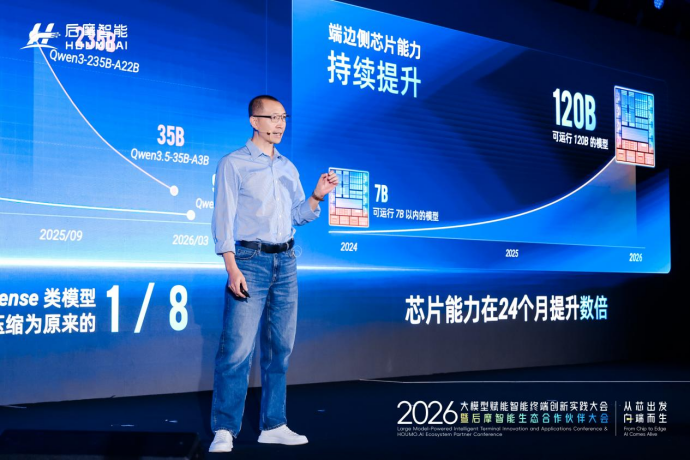
根据后摩智能联合创始人、产品副总裁信晓旭的介绍,在技术演进路线上,后摩智能规划了两条互补路径:一条是2D CIM路径,即以SRAM-CIM架构结合传统2D封装,面向高算力、大存储容量的应用场景;另一条是3D CIM路径,即在先进封装基础上,将逻辑层升级为存算一体架构,同时支持DRAM、Flash、RRAM等多种存储介质,目标是提升访存带宽与算力密度。
目前,后摩智能已形成从量产到规划的梯度化产品布局。其中,M30与M50两款芯片已实现量产,M50为当前旗舰产品。截至2026年8月,M50芯片已获得超过150项产品定点,覆盖多类端侧应用场景。
在研产品方面,A20为首颗基于3D CIM架构的芯片,已进入投产阶段。该产品具备高带宽、低时延特性,支持最多16颗芯片全互联,算力利用率较上一代提升50%,适配3B至30B参数规模的模型,主要面向Dense类产品场景。M6X系列为M50的迭代版本,综合性能预计达到M50的3至6倍。面向亿级消费终端市场的A30芯片则处于规划阶段,定位为高算力、低功耗产品。
后摩智能也在不断推进软件工具链的配套支撑,已完成vLLM、llama.cpp、SGLang等主流推理框架的适配优化;ModelZoo模型库覆盖大语言、多模态、语音、视频、具身智能等方向;同时提供中间件工具与场景化应用样例。操作系统层面,M50芯片已与Windows、Ubuntu、开源鸿蒙、安卓、麒麟、统信、欧拉等主流系统完成适配,并支持X86、ARM、RISC-V等主流CPU架构。
随着模型与芯片等基础底座不断完善,端侧AI的应用需求也在加速形成。论坛上,来自联想、中电长城、商汤科技、绿联、Deepshard、阿里云智能集团千问、万格智元的多位嘉宾均发言深入探讨了端侧AI的落地路径。2026年已被业界视为端侧AI发展的重要节点。