一、两条路线的分野:生态位与独占壁垒
1.1 两大阵营图谱
过去三年,全球大模型产业沿"开源"与"闭源"两条路线形成了泾渭分明的阵营格局。开源阵营中,国内以阿里巴巴通义千问(Qwen)、深度求索(DeepSeek)、智谱(GLM)、百川智能、零一万物的Yi系列和上海人工智能实验室书生·浦语(InternLM)为骨干,海外则以Meta的Llama和法国Mistral为代表,它们共同构成了全球开源梯队的核心。闭源阵营由OpenAI(GPT系列)、Anthropic(Claude)、谷歌(Gemini)、xAI(Grok)领衔,国内百度文心、字节豆包、科大讯飞星火、月之暗面Kimi、阶跃星辰等亦长期位列其中。
表1:全球大模型开源/闭源阵营图谱
阵营 | 区域 | 代表机构 | 代表模型 | 核心策略 |
开源 | 国内 | 阿里巴巴 | Qwen(通义千问) | 全尺寸开源、云生态协同 |
开源 | 国内 | 深度求索 | DeepSeek V3/R1/V4 | 极致性价比、全面开源 |
开源 | 国内 | 智谱 | GLM系列 | 开源生态、政企交付 |
开源 | 国内 | 百川智能 | Baichuan系列 | 医疗等垂直行业 |
开源 | 国内 | 零一万物 | Yi系列 | 企业级部署 |
开源 | 国内 | 上海人工智能实验室 | 书生·浦语(InternLM) | 学术与产业开源基座 |
开源 | 海外 | Meta | Llama 4 | 开源生态、规模优势 |
开源 | 海外 | Mistral AI | Mistral Large 3 | 欧洲主权、效率路线 |
闭源 | 海外 | OpenAI | GPT系列 | 能力独占、C端订阅 |
闭源 | 海外 | Anthropic | Claude系列 | 安全优先、企业级与编程 |
闭源 | 海外 | 谷歌 | Gemini系列 | 多模态、搜索场景 |
闭源 | 海外 | xAI | Grok 4 | 实时数据、推理能力 |
闭源 | 国内 | 字节跳动 | 豆包 | C端免费、流量变现 |
动态调整 | 国内 | 百度 | 文心 | 2025年宣布由闭源转向开源 |
动态调整 | 国内 | 月之暗面 | Kimi K2/K3 | 开放权重叠加商业分成条款 |
值得注意的是,阵营边界并非静止:百度于2025年2月宣布将于6月30日正式开源文心大模型,而此前其董事长李彦宏仍公开表示"大模型开源的意义不大";腾讯混元Hy3也于2026年7月以Apache 2.0协议开源;月之暗面Kimi K3则以"开放权重+收入分成"条款向海外服务商开放。与此同时,OpenAI发布了自2019年以来的首批开源大语言模型,其首席执行官亦公开承认此前的开源政策"站在了历史错误的一边"。两大路线正在彼此渗透。
1.2 本质差异:生态位与独占壁垒
两条路线的分野,根源在于商业模式与资本结构的差异。研究指出,开源的本质是"以放弃模型独占权换取生态位"——它对资本消耗更低,特别适合无法持续私募输血、或需要借开源建立生态话语权的玩家;闭源的本质则是"以巨额资本筑起模型能力的独占壁垒",依靠API订阅与企业合同变现,天然是巨头的副业和资本巨兽的主业。
闭源路线的代价是惊人的资金消耗:OpenAI一年运营亏损高达209.2亿美元;另据披露,其仅一年就"烧"掉50亿美元,2023年至2028年预计累计亏损440亿美元,2026年支出可能攀升至95亿美元。开源路线则以生态换收入:阿里、百度通过API降价50%并提供免费额度吸引开发者,DeepSeek利用MoE架构将推理成本降至国际同类产品的10%。
二、技术天平向开源倾斜:差距、成本与生态
2.1 性能差距:从代差到1.7%
斯坦福大学《AI Index Report 2025》显示,顶级闭源模型与最佳开源模型的性能差距已缩窄至1.7%。标志性案例不断涌现:2024年12月发布的DeepSeek-V3在多项评测中超越了阿里Qwen2.5-72B、Meta Llama-3.1-405B等开源模型,并逼近GPT-4o、Claude-3.5-Sonnet等顶尖闭源模型;2025年1月DeepSeek-R1发布,性能对标OpenAI o1正式版,并以MIT许可证允许全行业蒸馏;DeepSeek-V4-Pro在SWE-Bench Verified上得分91.2%,接近Claude Opus 4.7的93.9%,而成本仅为后者的约六分之一。Meta首席AI科学家杨立昆(Yann LeCun)由此评价:与其说中国公司在超越美国公司,不如说开源大模型正在超越闭源。
2.2 成本革命:DeepSeek效应
成本是开源路线最有力的武器。官方技术论文披露,DeepSeek-V3预训练仅使用2048块GPU、训练2个月,花费557.6万美元,而GPT-4o训练成本约1亿美元;达到与OpenAI o1相当的性能,耗费资金仅为其3%至5%。价格层面,DeepSeek-V3与R1的百万tokens输入(缓存命中)分别为0.5元和1元,输出分别为8元和16元,优惠时段再降一半,比OpenAI o1低一个数量级;作为参照,OpenAI GPT-5.5系列输入成本为每百万tokens 5至12美元、输出高达30至54美元。中国开源模型以约十分之一的成本提供接近顶尖闭源模型90%的能力,对全球中小企业和发展中国家的开发者而言几乎是唯一理性选择。
"DeepSeek斩杀线"由此成为行业热词:中国低价开源模型正在对美国AI公司的定价权发起挑战,OpenAI因成本过高放弃的视频生成等业务空白,正被中国企业迅速填补。阿里Qwen3.8-Flash更将每百万tokens价格压至输入1元、输出3元,仅为DeepSeek-V4-Flash的三分之一。
2.3 生态跃迁:开发者用脚投票
生态份额的变化更为剧烈。Hugging Face 2026年春季报告显示,中国开源模型已占该平台月度及总体下载量的41%,而2024年底这一比例仅为1.2%——一年多时间跃迁近40个百分点,全球开发者正在用脚投票。
【图表:中国开源模型占Hugging Face下载量比例变化】
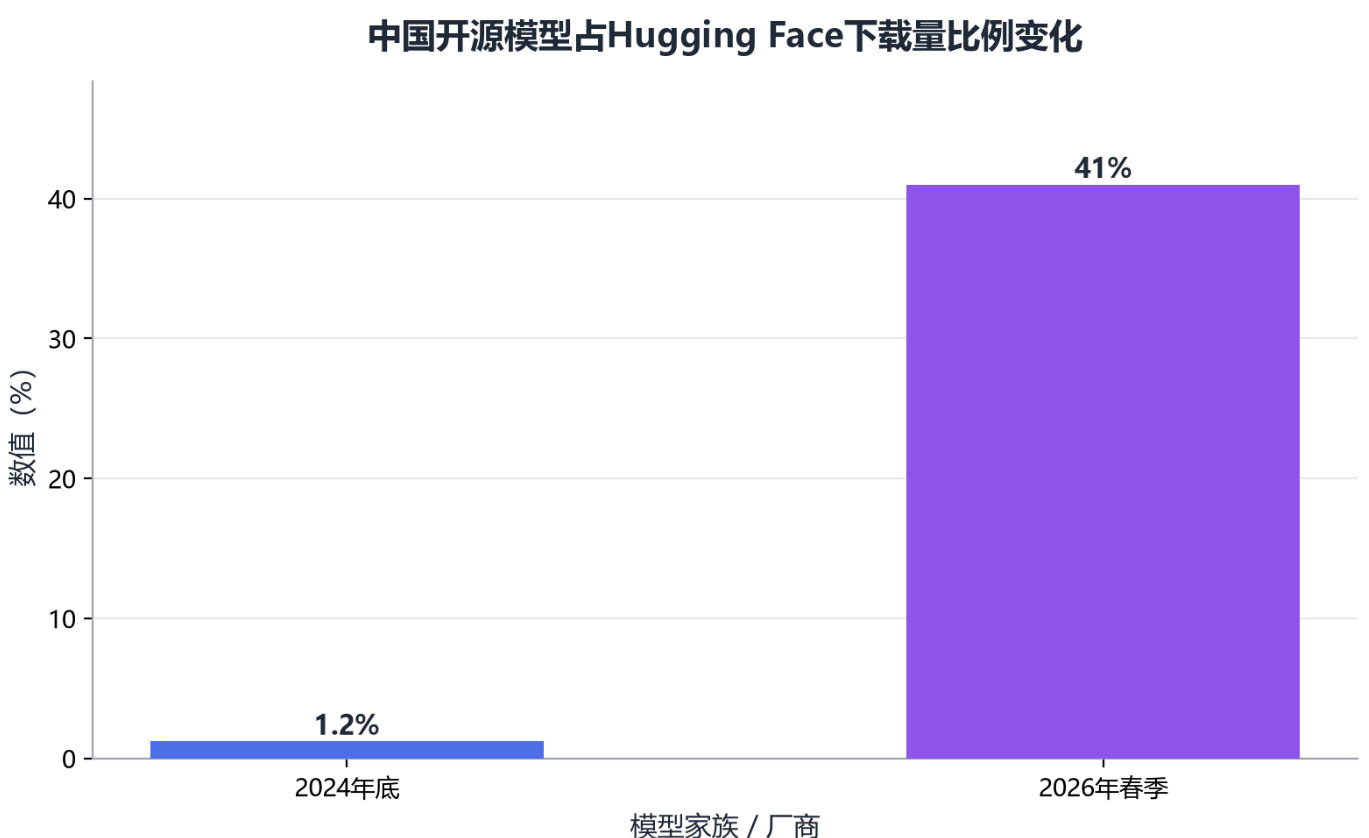
中国开源模型在Hugging Face平台的下载占比从2024年底的1.2%跃升至2026年春季的41%,约40个百分点的跃迁标志着全球开源生态主导权的历史性转移。
从头部模型家族看,2025年3月Meta Llama以单月0.66亿次下载位居全球最受欢迎开源模型第一,阿里通义(Qwen)以0.6亿次紧随其后,DeepSeek以0.243亿次位列第三。
【图表:2025年3月全球开源模型Hugging Face单月下载量对比】
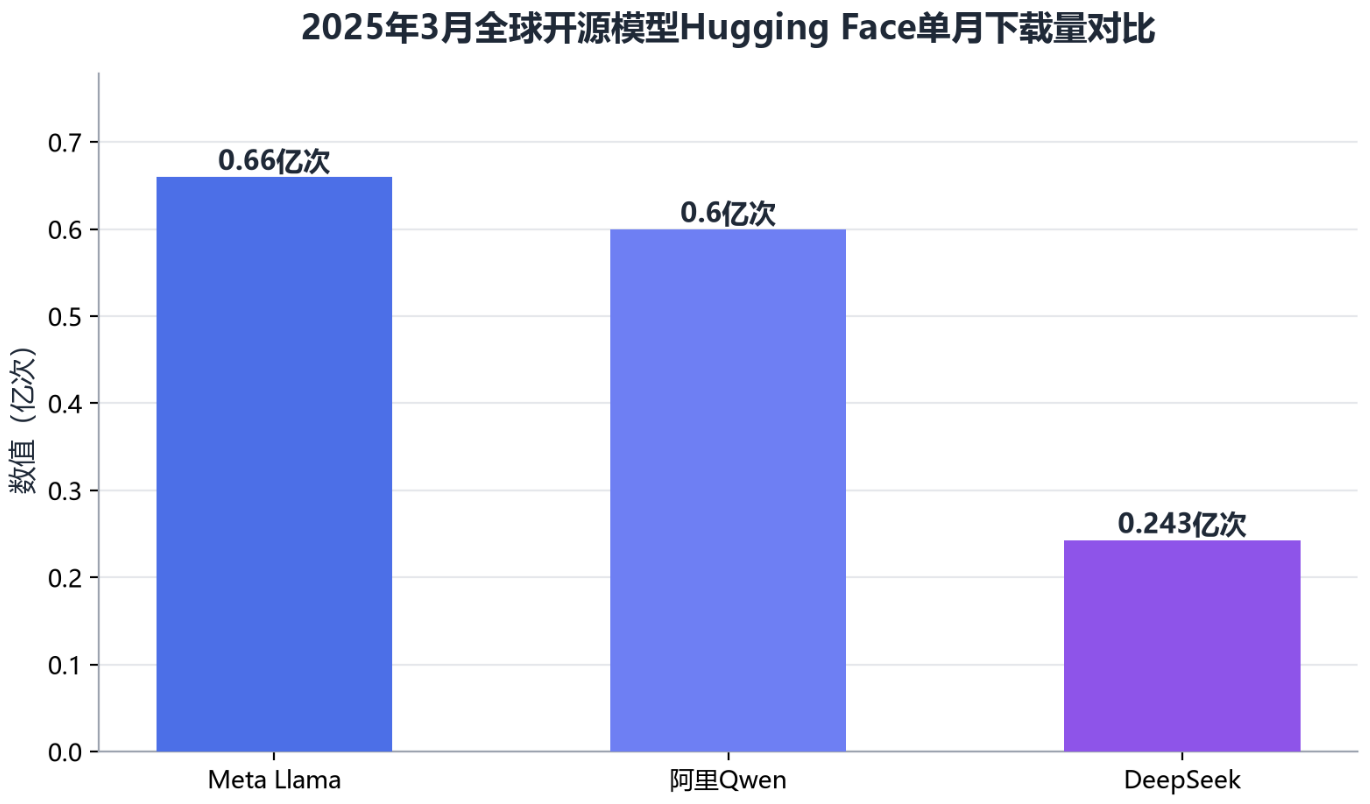
2025年3月,Llama、Qwen、DeepSeek三大家族合计单月下载超1.5亿次,Qwen与Llama的差距已缩小至600万次,中国开源模型的追赶速度肉眼可见。
到2026年8月,格局已被改写:Hugging Face《开放模型现状》报告显示,2026年至今Qwen在HF Hub的下载量达20.45亿次,同期谷歌约4.18亿次、Meta约2.27亿次,Qwen分别是它们的4.9倍和9倍;阿里已累计开源超460个Qwen模型、社区衍生模型超30万个,千问系列衍生模型在HF报告口径下超15.1万个、约为Meta整体的2.6倍,Qwen3.8-27B更成为HF历史上最受欢迎(Most Likes)的开源大模型。
【图表:2026年Hugging Face主要模型家族下载量对比】
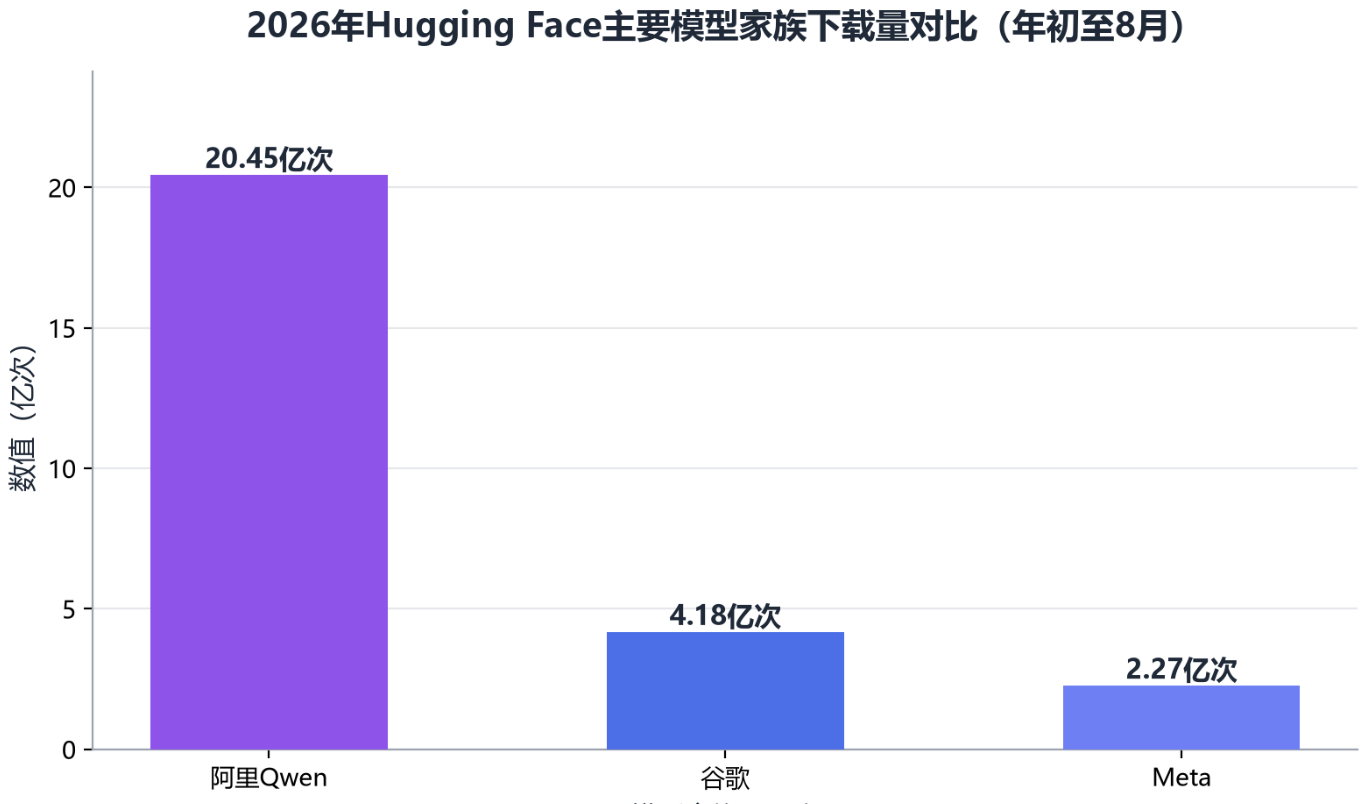
2026年年内,Qwen在HF Hub的下载量达20.45亿次,是谷歌的4.9倍、Meta的9倍,全球第一开源模型家族的地位已经确立。
在反映真实调用的OpenRouter开源token市场上,DeepSeek虽仍居开源模型贡献首位,但主导地位已被削弱:2025年7月以来,千问、Moonshot(Kimi)、OpenAI(gpt-oss)、MiniMax、智谱等模型大量涌入,DeepSeek份额降至约40%。
三、国内开源"集团军":从跟随到主导
3.1 Qwen:全球第一开源模型家族
阿里是这一轮全球开源浪潮的最大赢家。2024年6月,Qwen2-72B综合性能超越当时美国最强开源模型Llama3-70B;2026年8月3日发布的Qwen3.8-Max以2.4万亿参数成为全球规模第二大的开源大模型,并首次开源Max级旗舰,在Text Arena排名全球第5、Vision Arena全球第2。效率旗舰Qwen3.8-Flash以千亿总参数(1250亿)仅激活60亿的架构,实现训练成本骤降近90%。Qwen3.8-Max在Artificial Analysis上的得分从40升至45,与Claude、GPT最强模型同处第一阵营,领先于GLM5.3、Kimi-K3等所有国产模型。阿里研究员透露,Qwen4正采用全新架构展开训练,Qwen4.5、Qwen5参数规模计划迈向5万亿至10万亿。
组织与资本层面,阿里于2026年6月8日成立Token Foundry事业部,由集团CEO吴泳铭直接负责[28];其最新一个季度资本开支高达677亿元,过去5个季度有4个自由现金流为负,账上约4745亿元现金及流动投资托底,并通过港股配售募资约800亿港元投向AI基础设施。
3.2 DeepSeek:开源范式的搅局者
深度求索成立于2023年7月17日,由量化资管巨头幻方量化创立,是一家专注于通用人工智能研究的公司,创始团队自创立之初即立下"开源、降本与AI普惠"的理想主义路线。它先后开源了MLA解码核FlashMLA、DeepEP通信库、DeepGEMM代码库、3FS等底层组件,把模型背后的优化方法论一并交给社区,被从厂商比作"开放的安卓",与OpenAI相对封闭的"iOS"形成对照。OpenAI首席执行官奥尔特曼亦在o3-mini发布当天承认,OpenAI的开源政策站在了"历史错误的一边"。
梁文锋系统阐释过开源的底层逻辑:开源绝非营销手段,而是公司长期坚守的核心战略,未来顶尖模型也将持续开源;开源模型与内部自用模型完全对齐、零阉割;闭源模式短期可保护商业收益,长期容易造成技术封闭、生态固化。商业化上,DeepSeek追求合理利润而非利润最大化,主动将模型调用价格下调至原价的四分之一,以十个月收回设备成本为盈利标准,且暂无急迫上市计划,以规避资本市场短期业绩诉求对长周期AGI研发的绑架。其资金底座来自幻方量化——后者2025年收益率达56.55%,在管理规模超百亿元的量化私募中排名第二。
3.3 智谱、百川、Yi、书生·浦语:差异化卡位
智谱走"开源生态+政企交付"路线:一方面以开源吸引开发者生态,向B端和G端提供付费定制解决方案[14];另一方面持续突破智能密度上限构建MaaS商业体系,2025年营收7.24亿元,API平台年度经常性收入达17亿元、同比增长60倍,价格上涨83%后调用量仍保持增长。截至近期,智谱MaaS开放平台注册用户近700万,其中企业客户2.3万家,全年ARR增长15倍,有投资人预估年底ARR有望达到20亿美元。最新开源的GLM-5.3-Flash总参数3200亿、激活180亿。
百川智能选择医疗垂直赛道,利用自建数据集提升诊断模型精准度[9];零一万物聚焦企业级部署,通过模块化实现成本可控的商用落地,此后将其基础模型板块与阿里整合、转向上层应用与入口;上海人工智能实验室的书生·浦语(InternLM)则持续充当学术与产业之间的开源基座。
3.4 闭源阵营的松动
DeepSeek冲击之下,国内闭源阵营接连"倒戈":百度宣布6月30日开源文心并让文心一言全面免费[18];腾讯混元Hy3正式版于2026年7月6日发布并开源(Apache 2.0),按OpenRouter的token消耗量计持续位列全球前三,不过在独立评测机构Artificial Analysis的Intelligence Index上得分41.9,与阿里Qwen3.7-Max的56.6、DeepSeek V4 Pro的51.5仍有近10分档位差距;字节跳动则继续坚守闭源,豆包背靠字节的流量与广告变现体系,以C端免费做到国内用户规模最大的AI原生应用。月之暗面转向"开放权重+商业分成":Kimi K3要求年收入超2000万美元的商用服务商分享收入,据传比例高达30%,中国IT服务商中软国际已披露达成此类协议。
四、海外两条路线:Llama坚守与闭源联盟
4.1 Meta:Llama的开源坚守与被反超
Llama是Meta于2023年2月推出的开源大语言模型系列,初期作为研究工具向学术界开放并对商业用途提出许可条件,其推理代码通过GitHub向个人、创作者、研究者和各类企业开放。2025年二季度发布的Llama 4首次将多模态处理作为核心能力集成,实现文本、图像、音频、视频的统一理解与生成[23]。Meta坚持"Llama4开源权重、依托社交图数据构建生态"的路线。
但开源龙头正在易位:2025年3月,Llama单月0.66亿次的下载量还被Qwen以0.6亿次紧咬;到2026年,Meta在HF Hub的年内下载量约2.27亿次,仅相当于Qwen(20.45亿次)的九分之一;千问系列衍生模型数量已达Meta整体的2.6倍。Llama 3.3 70B等模型虽仍停留在OpenRouter开源token榜前列,但全球开源生态的主导权已向中国模型家族转移。
4.2 Mistral与Cohere:主权路线与企业级RAG
法国Mistral AI以Mistral Large 3主打欧洲主权与效率路线,估值135亿美元[2];其Mistral Nemo亦进入OpenRouter开源token榜前15。加拿大Cohere以Command R+专注企业级RAG(检索增强生成)市场,估值68亿美元。两者代表了美国闭源联盟之外,海外阵营在"主权合规"与"企业服务"两个缝隙市场的生存策略。
4.3 闭源巨头联盟:护城河与焦虑
闭源联盟依然握有最强的收入能力。按行业研究数据,OpenAI以GPT系列实现约250亿美元收入,占全球35%份额、企业级市场份额25%,核心优势是生态与先发;Anthropic以安全优先+闭源路线拿下15%的全球份额,企业级份额32%反超OpenAI;谷歌依托多模态与搜索场景占28%;DeepSeek以性价比与本土化占8%。
【图表:全球大模型厂商收入份额对比】
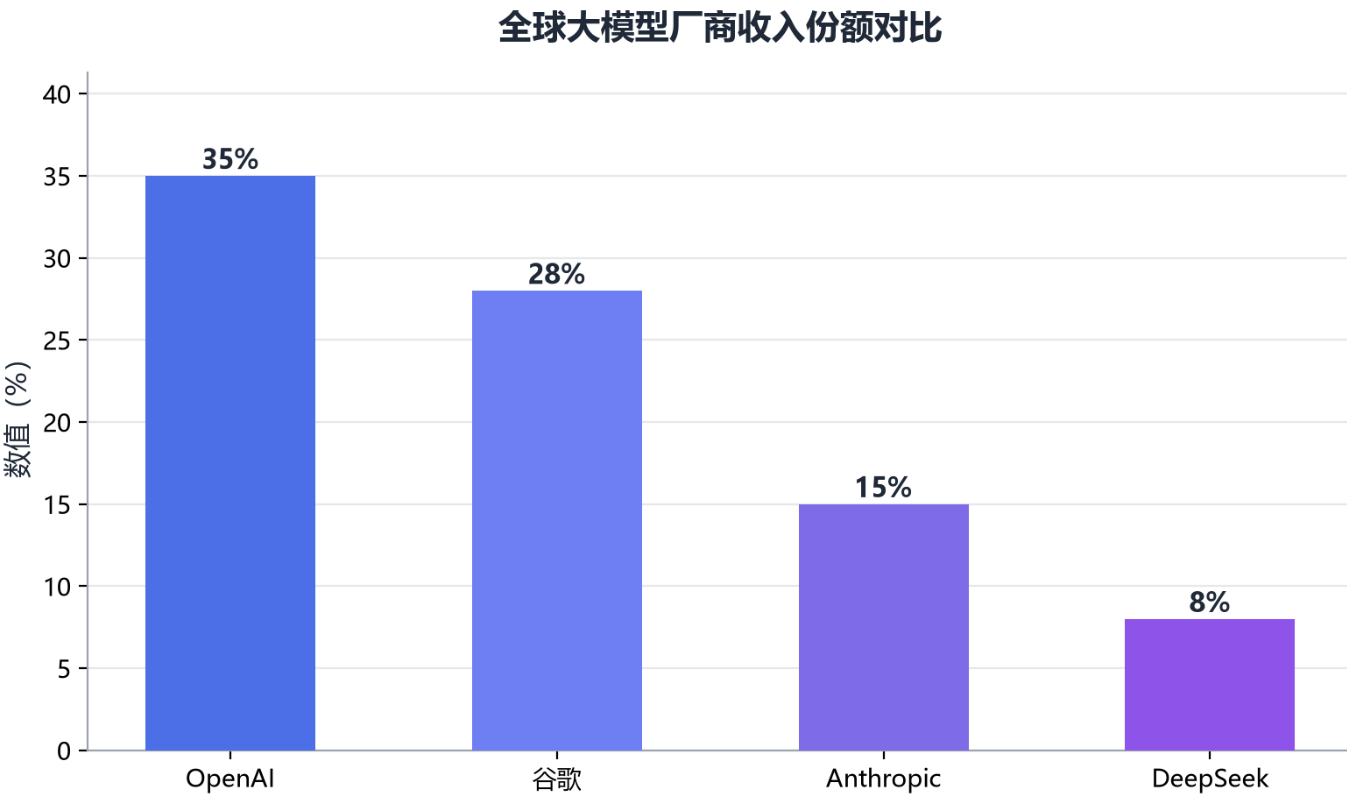
OpenAI以35%的全球收入份额居首,谷歌、Anthropic分列二三位,DeepSeek以8%的份额成为前四中唯一的中国厂商,开源阵营已在全球收入版图中占据一席。
需要说明的是,不同研究口径存在差异:另有分析称,Anthropic以仅约OpenAI七分之一的活跃用户,拿下了全球LLM市场31.4%的收入份额,与上述15%的口径不一致(统计范围不同所致),本文绘图以前一研究为准。
闭源的焦虑同样真实。Anthropic在2025年实现约46亿美元收入的同时,算力及基础设施相关支出达约73亿美元,经营亏损约80.6亿美元;OpenAI的巨额亏损仍在扩大。更重要的是,Anthropic的活跃用户只有OpenAI的七分之一,却能以编程和办公场景的高付费密度取胜——这印证了"用户为生产力付费"的闭源变现逻辑,编程和办公也正是能够支撑万亿美元市值公司的两条赛道。闭源联盟的另一张牌是资本:OpenAI与Anthropic均在筹备首次公开募股,目标估值至少达到万亿美元级别;xAI通过与SpaceX合并获得1.75万亿美元估值。
五、路线适配:谁该选开源,谁该选闭源
5.1 开源的腹地:私有化部署与行业客户
从商业模式看,大模型变现已分化为API订阅、行业专属私有化部署和Agent平台三种方式;与API订阅相比,私有化部署单价高、交付重,是面向高敏感行业的标准方案。券商研究进一步刻画了其画像:私有化部署/一体机模式采取"一次性许可+年维护服务费(百万级起)"定价,主要客户为政府、金融、医疗、军工机构,毛利高、迁移成本大、黏性强;行业大模型深度定制采取"项目制+数据与运营分成",客单价最高但周期最长。
这正是闭源模型进不来的市场。多位从厂商指出,国内企业大量需求是私有化部署与微调定制,海外低价闭源API夺不走这部分需求;海外同样存在大量私有化部署与定制化需求,开源生态(如DeepSeek开放权重)能承接,这是闭源API给不了的护城河。
落地案例已密集出现:DeepSeek大火之后一体机大行其道,其上往往同时搭载DeepSeek与阿里等公司的开源模型;光环新网完成DeepSeek本地私有化部署适配,客户可通过企业内网快速拉取DeepSeek-R1模型镜像,解决知识库敏感信息读取与数据泄露风险;开普云在智能体中台中无缝集成DeepSeek本地化部署,服务北京国资公司等多个客户;金融领域已有超数十家头部企业完成开源模型部署,应用于精准产品推荐、沉浸式培训模拟、智能理赔等场景。对跨国经营场景而言,开源模型"数据不出境"的方案,比使用美国公司的闭源云服务更让企业安心。
5.2 闭源的腹地:C端产品与高安全企业服务
C端市场仍由闭源产品主导。豆包背靠字节的流量与广告变现体系,靠C端免费做到国内用户规模最大的AI原生应用,免费本身就是获客手段。在国内,免费已是用户的默认预期,谁先收费谁就可能先流失用户,缺少订阅产品兜底的厂商难以复制Anthropic依靠Claude Code开发者订阅与企业席位的打法。OpenAI的ChatGPT同样是闭源C端变现的极致样本,但其代价是持续巨额亏损。
高安全与高可靠的企业服务是闭源的另一腹地。"如果你用开源模型,就没有原厂的支持",亚信科技副总裁、云事业部总经理傅葳指出,企业落地大模型过程中,开源和闭源的区别很大程度上是大模型原厂的支持力度,闭源模型迭代速度更快。Anthropic以"安全优先+闭源"拿下32%的企业级份额,在企业级、编程与安全场景建立心智。需要提醒的是,开源私有化部署并不意味着天然安全——安全厂商永信至诚即指出,用户完成私有化部署后数据虽不出域,但私有化部署不等于安全,并据此推出原生安全大模型一体机,这也为"开源底座+安全服务"的混合模式留下空间。
5.3 混合策略与落地警示
不少厂商选择双线作战。阶跃星辰既有开源模型也有闭源模型,其副总裁李璟认为,开源策略带来更多的是技术影响力,"好的商业模式还是闭源"。对企业用户,行业观察给出了明确的警示:大型企业虽愿基于开源模型自建适配,但单行业、单客户的经验迭代速度非常慢,不少企业自己部署开源大模型,做到六七成时发现无法真正落地,甚至很多企业做到三成时就放弃。从厂商的共识性建议是"补结构":建立旗舰+小模型+免费端的三层结构,同时放大开源——开源生态、私有化部署、定制化服务,是国内厂商手里唯一不依赖裸价的牌。
价格战也让纯API模式难以为继。DeepSeek等开源模型将Token定价基准拉至历史低位,使依赖API收费的商业模式面临根本性盈利压力,整个行业被迫重新寻找可持续的变现路径;2026年8月6日,DeepSeek公告计划整体上调API服务定价,且预计涨幅较大。
六、资本视角:上市公司与初创的开源策略差异
6.1 上市公司:开源是主业生态的放大器
对上市公司而言,开源不是生意本身,而是主业的放大器。阿里的Qwen系列通过全模态开源吸引开发者使用云计算等基础设施,模型前期只是引子,明码标价的商品实则是云服务,形成"生态捆绑"的开源变现模式[14];其开源力度持续加码——从Qwen2-72B到首次开源Max级旗舰的Qwen3.8-Max,并以组织升级(Token Foundry事业部、CEO直管)保障战略执行[28]。腾讯开源混元Hy3后,自己清楚靠榜单已经追不上,所以换了赛道,将模型能力嵌入社交、游戏与云的既有版图。百度从"开源意义不大"到宣布开源文心,本质是以开源守住搜索与云的入口。Meta则以Llama换取全球开发者生态位,为广告与社交主业输送AI能力。
上市公司的共同特征是:模型不承担独立盈利压力,开源带来的生态溢价最终沉淀在云收入、广告效率与企业服务上;巨额算力开支由主业现金流与资本市场融资支撑——阿里单季677亿元资本开支、字节年度1500亿至2000亿元的AI相关投入与约300亿美元银团贷款皆是明证。
6.2 初创公司:开源是生存策略与融资叙事
初创公司没有云业务兜底,开源对它们是更残酷的生存计算。DeepSeek是全球唯一由量化对冲基金持续供养的前沿AI实验室,幻方量化2025年56.55%的收益率构成其资金底座,梁文锋在本轮融资中个人出资200亿元、约占40%,以维持绝对控制权;公司暂无急迫上市计划,以规避资本市场短期业绩诉求对长周期科研的绑架。
已上市或临近上市的初创则把开源与资本市场叙事绑定。智谱选择"开源吸引开发者生态、B端G端定制付费"的组合拳,其6000亿港元左右的市值与ARR增长15倍的增速互为因果;MiniMax通过模型与应用产品推动全球调用量增长,2026年上半年营收约1.17亿美元、同比增长283.1%,毛利率17.9%,经调整净亏损约2.93亿美元,开放平台及其他AI企业服务收入占比升至63.4%,8月ARR超过8亿美元;估值500亿美元的月之暗面已走到上市门口,K3的开放权重+收入分成条款既是生态武器,也是IPO前商业可持续性的证明。
资本市场的账本印证了开源的"延迟变现"逻辑:中国开源模型消化了2000亿至3000亿元人民币的ARR空间,按20倍ARR估值对应4万亿至6万亿元的市值转移,而当前DeepSeek、Kimi、智谱、MiniMax等只承接了五分之一到三分之一的估值空间——被开源模式推迟的变现,可能沉淀为中国开源模型公司的潜在收益。
6.3 从免费到收费:开源商业模式的收敛
开源正在从"纯免费"走向"开放权重+分层收费+商业分成"。路透社独家报道,阿里计划对下一版Qwen开源模型的重度商用用户收取收入分成,要求年销售额超一定门槛的客户签署商业协议,此举效仿月之暗面Kimi K3的条款。许可层面,通义千问GitHub代码遵循Apache 2.0,模型权重则采用《通义千问许可协议》中的约束条件、禁止大规模商业使用——"代码开放和权重受限"的混合开源策略,在带来技术扩散生态效益的同时,通过法律阈值保护开源企业的商业权益。海外厂商已开始承接这一模式:美国DigitalOcean已提供Kimi K3等中国模型,其CEO称该模式成熟,且Kimi K3成本仅为Anthropic同类的约三分之一。
提价与分成的底气来自效率:智谱API价格上涨83%后调用量不降反升;企业部署开源模型并非商业的结束,企业提价反而促进用户更多关注效率效果,是全新合作模式的开始。开源的第一笔生意是高性能API销售——基础服务免费,但按调用量收费的付费API承接稳定性需求。
七、结论与展望
第一,技术天平已向开源倾斜,但收入天平仍偏向闭源。开源把与闭源的性能差距追至1.7%,把中国开源模型的HF下载份额从1.2%推至41%;但OpenAI与Anthropic仍握有全球最重要的付费场景,闭源在企业级与编程办公市场的收入优势短期内难以撼动。
第二,路线适配大于路线优劣。开源的腹地在私有化部署、行业客户与数据不出境场景;闭源的腹地在C端产品与高安全企业服务。两条边界正在"安全私有化"地带交汇,"开源底座+闭源安全与交付服务"的混合模式将成为行业主流形态。
第三,开源商业模式正在收敛为"开放权重+分层收费+商业分成"。从Qwen收入分成、Kimi K3条款到DeepSeek上调API定价,免费开源与闭源订阅之间的大量中间形态将被陆续验证。
第四,资本结构决定开源策略。上市公司以开源放大云与生态(阿里、腾讯、百度、Meta),初创以开源换取生态位与融资时间(DeepSeek、智谱、月之暗面);没有云业务兜底的玩家,必须在量化利润供养、IPO变现、被生态整合三条路中尽早选边。
展望未来,三个变量值得跟踪:一是算力供给——梁文锋坦言芯片而非人才是中美AI公司之间最关键的差距,国内头部实验室获得的高端芯片数量往往只有海外同行的五分之一;二是Agent调用拐点——智能体驱动的模型调用正进入加速期,开源token市场的多极化将持续;三是监管与许可约束——开源许可的结构性变迁(自拟许可与双重授权)正在重塑产业规则,企业须在公共基础设施属性与商业竞争属性之间寻找平衡。