第一章 事件切入:圣何塞的一声枪响,Maia 300 正式亮相
美国西部时间 10 月 12 日,圣何塞 OCP 全球峰会现场,微软执行副总裁 Scott Guthrie 登台宣布:第三代自研 AI 推理芯片 Azure Maia 300 正式发布。这场发布之所以引人注目,不在于一颗芯片本身,而在于微软给出的两个"量级表述"——Azure Maia 系列将迈向多吉瓦级(multi-gigawatt)部署,且 2027 年起 Maia 300 开始大规模生产部署、并成为微软产品与服务的主要 AI 推理系统。
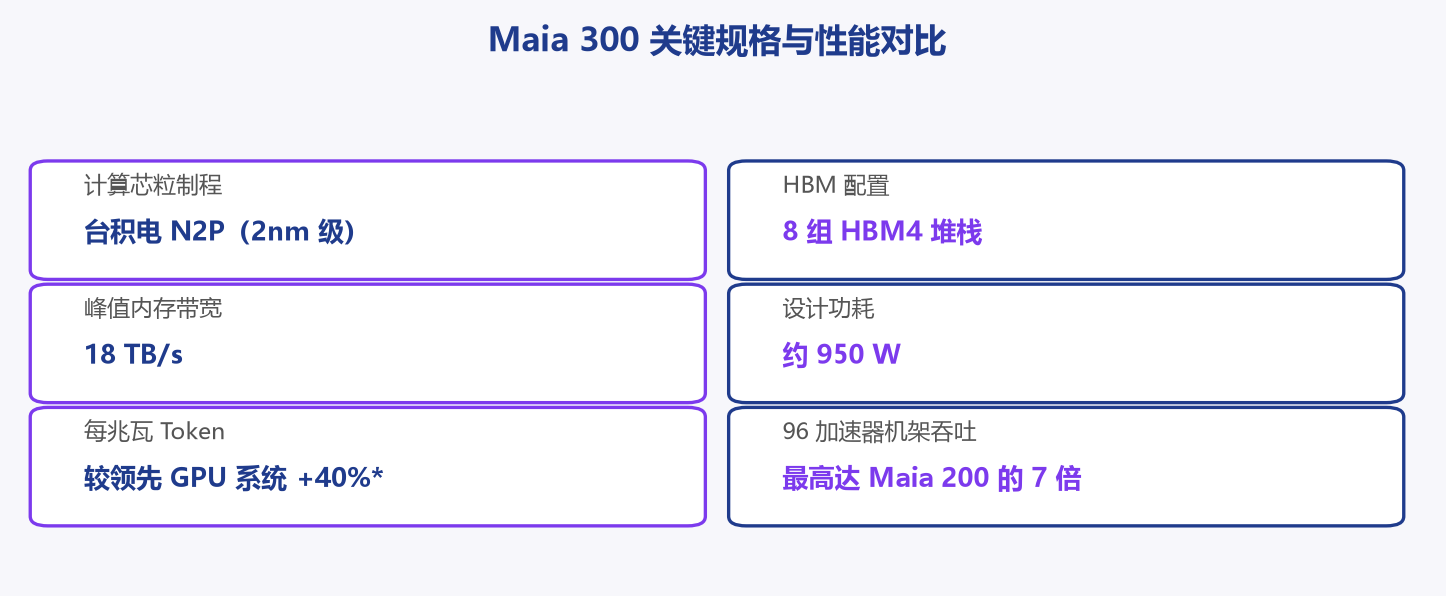
性能层面,微软给出的两组官方数据颇具冲击力:其一,Maia 300 每兆瓦可处理的 Token 数较领先 GPU 系统高出 40%;其二,搭载 96 颗 Maia 300 加速器的整机柜,Token 吞吐量最高可达上一代 Maia 200 机架的 7 倍,机架功耗约 167 千瓦——作为参照,GB300 机架集成 72 颗 GPU、功耗约 142 千瓦。
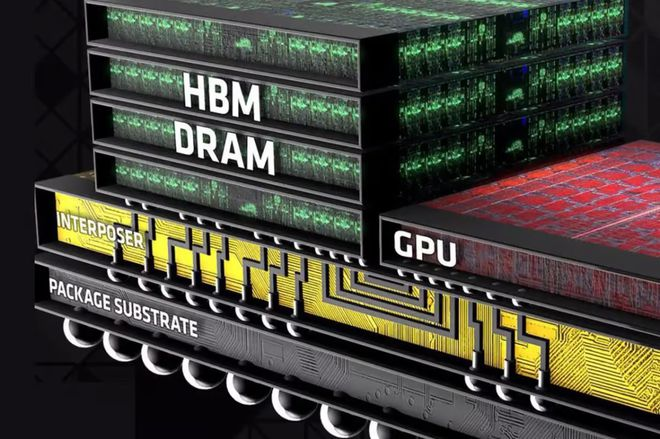
硬件规格方面,Maia 300 的计算芯粒采用台积电 N2P(2nm 级)工艺,每颗芯片配置 8 组 HBM4 堆栈、峰值内存带宽 18TB/s,设计功耗约 950W。从制程、内存堆叠到带宽,这几乎是一颗顶格堆料的推理旗舰,也意味着微软把"推理主系统"的战略直接压在了最新工艺与最新内存代际之上。
值得注意的是,Maia 300 并非从零起步——上一代 Maia 200(2026 年 1 月发布,已部署于亚利桑那州、爱荷华州数据中心)已经跑通生产负载:现承载 Microsoft Copilot 等服务、运行 OpenAI 与微软 MAI 模型,GitHub Copilot 与 Microsoft Foundry 也将在年底前接入。纳德拉在 4 月财报电话会上披露,Maia 200 每美元 Token 输出能力提升超 30%,每瓦 Token 数为竞品 GPU 系统的 1.7 倍。这一"效率基线"为 Maia 300 的说服力提供了现实注脚——自研芯片不再是技术展示,而是可验证的成本曲线。
资本市场当日给出正面反馈:10 月 12 日微软股价收涨 1.14%、报 541.15 美元,市值重返 4 万亿美元上方。
但更值得注意的是发布背后的"分层现实"。第三方机构 Evercore ISI 测算,到 2027 年初,Maia 也仅占微软 AI 芯片支出的约 10%——即便到 2027 年,微软绝大部分算力供给仍来自英伟达等外部供应商。而据媒体报道,微软正与台积电洽谈 2027 年交付逾 30 万枚 Maia 300 芯片的产能合同,Reuters 援引知情人士称 2027 年潜在部署量或超 100 万颗——需强调,该数字为媒体援引知情人士的报道口径,微软官方并未确认。可以确定的是母公司弹药充足:微软先前已表示,2026 自然年资本支出预计超过 1,750 亿美元。
Maia 300 的发布,标志着头部云厂商的自研芯片从"辅助角色"进入"主力推理系统"阶段;但 Evercore ISI 约 10% 的支出占比测算提醒我们,这是一个渐进替代的过程,而非一夜革命。真正的产业级冲击波,正在由这场发布沿产业链向上游与同行两个方向传导。
第二章 云厂商自研芯片浪潮:从单点突破到集团军作战
微软 Maia 300 并非孤例。过去半年,全球头部云厂商的自研芯片叙事几乎同步加速,且首次出现了"百万芯片级"的基础设施量级。
谷歌是这个方向的先行者。2026 年 9 月 16 日,谷歌在 SEMICON Taiwan 2026 宣布,其 TPU 互联架构已支持最多 100 万颗 TPU 芯片连接为统一计算集群——AI 算力基建正式迈入"百万芯片级"。当前主力 TPU v7 Ironwood 单芯片 FP8 算力达 4,614 TFLOPS,9,216 颗芯片组成的 Pod 可提供 42.5 Exaflops 算力,配置 192GB HBM、带宽 7.37TB/s,能效较上代 Trillium 提升 2 倍。
商业侧的绑定同样纵深。谷歌与 Anthropic 的 TPU 协议涉及最多约 100 万颗 TPU、总功率超 1 吉瓦,且自 2027 年起将提供 3.5–5 吉瓦的 TPU 算力容量,交易价值最高约 400 亿美元。亚马逊阵营的动作同量级:2026 年 4 月 20 日,亚马逊宣布对 Anthropic 追加投资至多约 250 亿美元,Anthropic 承诺十年内在 AWS 支出超 1,000 亿美元,新增至多 5 吉瓦 Trainium 算力,2026 年底前约 1 吉瓦 Trainium2+3 上线。AWS 的自研芯片业务本身也已长成大象——2026 年第一季度,Trainium/Graviton/Nitro 自研芯片年化营收突破 200 亿美元、同比增速超三位数,Trainium2 售罄、Trainium3 已基本订满,累计 Trainium 长期合同承诺约 2,250 亿美元。Meta 则承诺未来 12 个月自研芯片(MTIA)部署超 1 吉瓦用电当量,MTIA 450(Arke)将于 2027 年上半年进入数据中心。
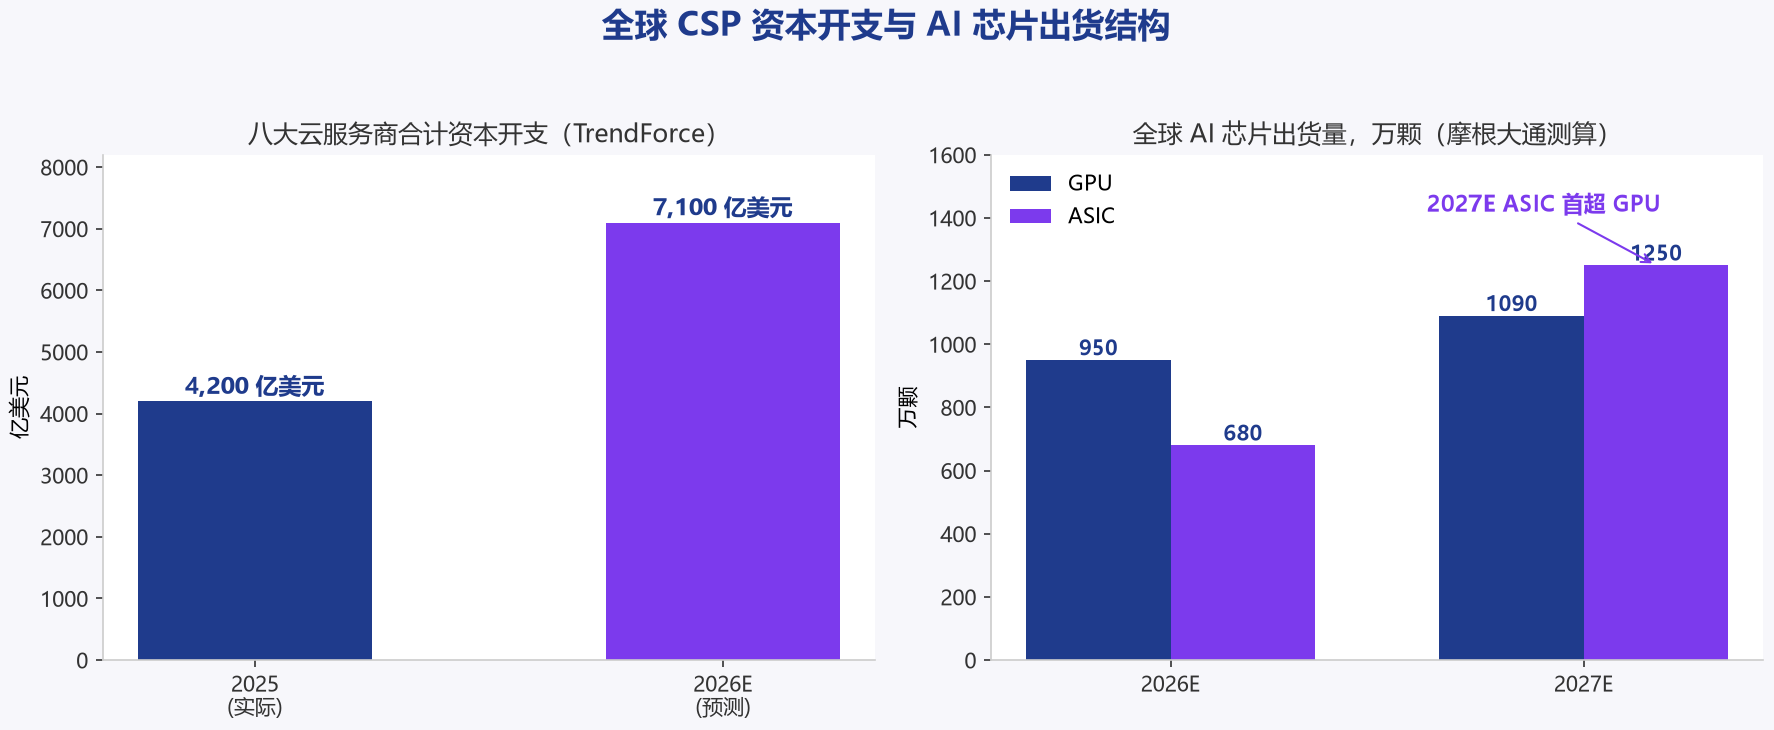
经济性是这一浪潮的根本驱动。谷歌云 CEO Thomas Kurian 在 9 月高盛通信+技术大会上表示,平均 AI 服务器投资回收用时不到 2 年,而自研芯片方案的回收期仅为 GPU 方案的一半。当自研芯片能把投资回收周期压缩一半,云厂商的资本开支便有了持续加码的财务逻辑——TrendForce 统计,全球八大云服务商合计资本开支 2025 年突破 4,200 亿美元(同比+61%),2026 年预估突破 7,100 亿美元。
结果直接反映在出货结构上。摩根大通测算,2026 年全球 ASIC 出货约 680 万颗(占 AI 芯片出货约 42%),2027 年 ASIC 出货约 1,250 万颗、占比 53%,将首次超过 GPU 的 1,090 万颗(DIGITIMES 另有 2027 年高端云端 AI 加速器中 ASIC 1,526 万颗的口径)。TrendForce 的服务器口径同样印证:2026 年 ASIC 服务器出货增速达 44.6%,约为 GPU 服务器增速(16.1%)的近 3 倍;AI 服务器芯片结构中 GPU 占 69.7%,ASIC 份额由 20.9% 升至 27.8%。
设计服务环节则是最直接的受益者。博通 FY2026 财年 AI 收入指引约 560–580 亿美元,FY2027"可见"收入超 1,000 亿美元,定制硅片在手订单(18 个月窗口)约 730 亿美元;Marvell 在 10 月 6 日投资者日将 FY2028 定制 AI 芯片营收目标上调至 180 亿美元,FY2029 定制芯片营收目标上调至超 120 亿美元。市场规模层面,Counterpoint 预计全球 AI ASIC 市场将从 2024 年的约 120 亿美元增至 2027 年约 300 亿美元(CAGR 约 34%),Marvell 则预测 2023 年 66 亿美元 → 2028 年 554 亿美元(CAGR 53%),博通给出 2027 年定制 AI 芯片市场 600–900 亿美元的宽口径判断。
当谷歌、亚马逊、Meta、微软四家的自研芯片全部进入吉瓦级部署轨道,"自研 vs 外购"已不再是选择题,而是配比题。ASIC 出货量 2027 年首超 GPU 的拐点预测(摩根大通),意味着 AI 算力供给侧正从"英伟达定义一切"走向"分层供给"——而这一结构变迁的全部重量,最终都压在了上游供应链的肩上。
【图 2】全球 CSP 资本开支与 AI 芯片出货结构
第三章 上游供应链:一切繁荣的"卡脖子"环节
无论自研还是外购,所有 AI 算力最终都要在同一批先进封装产线和同一批 HBM 颗粒上排队。上游,才是本轮变局中最刚性的瓶颈。
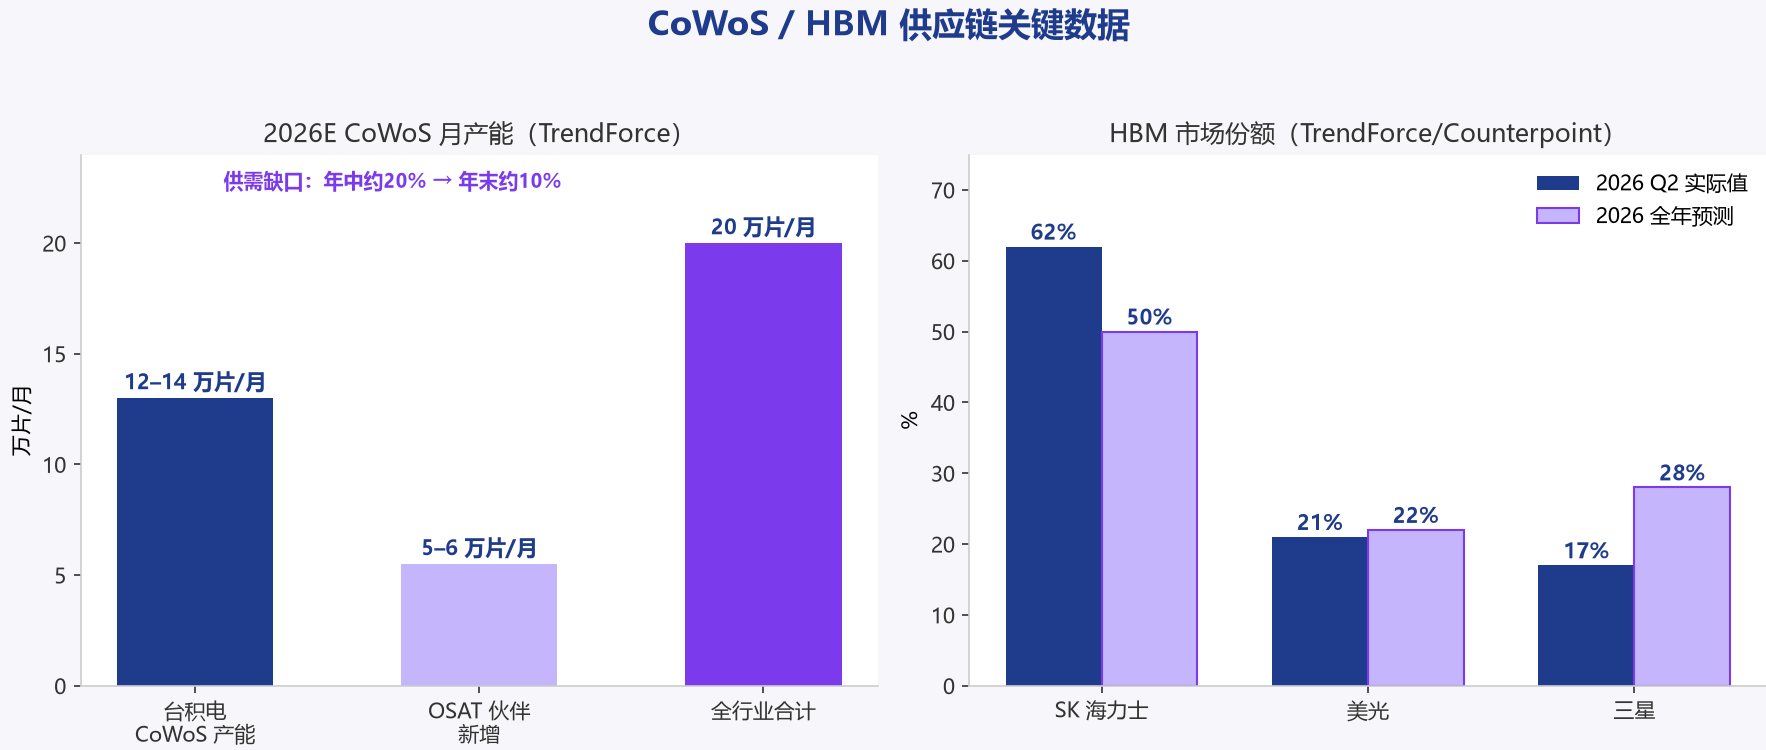
先进封装侧,台积电 CoWoS 月产能 2026 年预计达 12 万–14 万片/月的历史高位,叠加 OSAT 伙伴新增的 5 万–6 万片,全行业月产能接近 20 万片。即便如此,供需缺口仍将从 2026 年年中的约 20% 收窄至年末的约 10%,严重短缺要到 2027 年才明显缓解。更关键的结构性事实是:英伟达一家就锁定了 2026 年约 60% 的 CoWoS 产能。这意味着微软、谷歌、亚马逊的自研芯片想要爬坡,不仅要与英伟达竞争终端市场,还要在同一批封装产线上与其抢产能——这构成了自研芯片放量的最大物理约束。
需求端的火热有月度数据背书。台积电 2026 年 8 月合并营收达 5,148.06 亿新台币(约 163.5 亿美元),同比+53.3%、环比+10.1%,创单月历史新高;1–8 月累计营收约 3.39 万亿新台币,同比+39.3%。产能规划上,台积电已将 2026 年全年资本开支预期上调至创纪录的 600 亿–640 亿美元。
存储侧,HBM 的格局同样集中且紧张。2026 年第二季度,SK 海力士、美光、三星分别占 HBM 市场约 62%、21%、17%;TrendForce 预计 2026 全年份额为 SK 海力士约 50%、三星约 28%、美光约 22%(全年预测值),三大厂 2026 年 HBM 产能已全部售罄,SK 海力士已于 2026 年 2 月全球率先量产 HBM4。市场规模方面,按美光口径,HBM 总潜在市场(TAM)将从 2025 年约 350 亿美元增至 2028 年约 1,000 亿美元。
产业链的外溢效应已经显性化:10 月 8 日,GlobalFoundries 官宣与台积电达成 20 亿美元、五年期制造合作协议,为台积电 CoWoS 先进封装供应硅中介层——连成熟制程代工厂都切入先进封装链条,足见瓶颈环节的稀缺性。
CoWoS 缺口、HBM 售罄、资本开支创纪录、硅中介层大单——四条线索指向同一个结论:2026–2027 年 AI 算力的真实约束不在需求,而在封装与存储产能。谁能锁定上游产能,谁就握住了自研芯片战略的咽喉;这也解释了为什么微软要"据媒体报道"与台积电洽谈数十万枚量级的产能合同。
【图 3】CoWoS/HBM 供应链关键数据
第四章 英伟达护城河:被追赶的领跑者依然领先
自研浪潮之下,英伟达的处境常被描绘成"守城者"。但从财务数据看,这场围城战远未伤及根本。
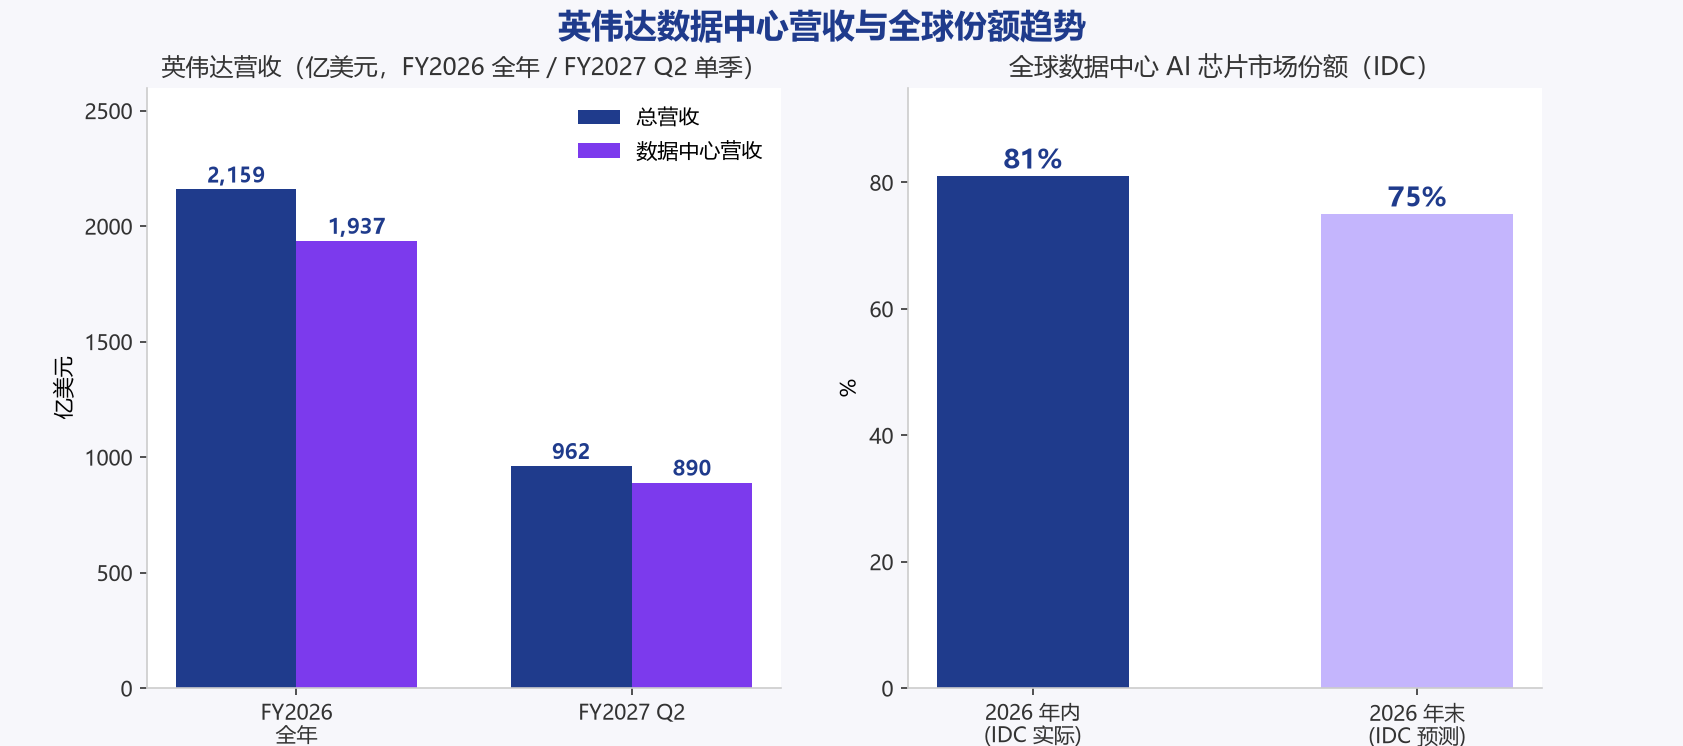
市场份额上,IDC 统计 2026 年英伟达在全球数据中心 AI 芯片市场仍占约 81%,AMD 约 10%,TPU、Trainium 等定制超大规模芯片合计约 5%;IDC 同时预测 2026 年末该份额将降至约 75%。财务面,英伟达 2026 财年(截至 2026 年 1 月 25 日)全年营收 2,159 亿美元(+65%),其中数据中心营收 1,937 亿美元(+68%)(英伟达 10-K);2027 财年第二季度(截至 2026 年 7 月)营收 962.21 亿美元(+106%),数据中心营收 890.23 亿美元(+117%),GAAP 净利润 596.88 亿美元(+126%),毛利率 75.0%,并给出第三财季 1,080 亿美元(±2%)的营收指引。管理层在财报电话会上进一步给出 2028 财年营收同比增长约 70% 的指引(供给受限口径),隐含营收约 7,000 亿美元,云服务行业未完成订单超 2 万亿美元,供给/产能承诺从上季的 1,190 亿美元增至 2,790 亿美元。资本市场同样给予定价:10 月初英伟达股价创历史新高,市值重返约 5.6–5.8 万亿美元区间,逼近 6 万亿美元里程碑。
护城河的深层结构在于生态与订单。英伟达软件开发者已超 650 万(其中 CUDA 开发者超 600 万),全球已部署数亿块英伟达 GPU。订单可见度方面,黄仁勋在 GTC 2025 给出 5,000 亿美元订单可见度(2025 年初至 2026 年底),此后上调至约 1 万亿美元(至 2027 年底)。产品节奏上,Blackwell 之后 Rubin 架构接棒,与云厂商自研芯片的代际迭代形成正面竞争——事实上,Maia 300 官方对标所称"领先 GPU 系统"、以及第一章所述机架功耗与 GB300 的对比,本身也说明:即便是最激进的自研阵营,仍以英伟达产品为性能标尺。
81% 的份额与 5.6–5.8 万亿美元的市值说明,自研芯片的替代是"从 81% 起步的缓慢侵蚀",而非颠覆。但方向已经清晰:IDC 预测的年末降至 75%,与摩根大通"2027 年 ASIC 首超 GPU"的出货预测相互呼应——英伟达的护城河足够深,护城河外的世界也在加速生长。
【图 4】英伟达数据中心营收与全球份额趋势
第五章 中国启示:另一条平行演化的产业链
当全球视野聚焦圣何塞时,中国市场正沿着一条受供给约束塑造、由政策与国产替代双轮驱动的平行路径快速演化。
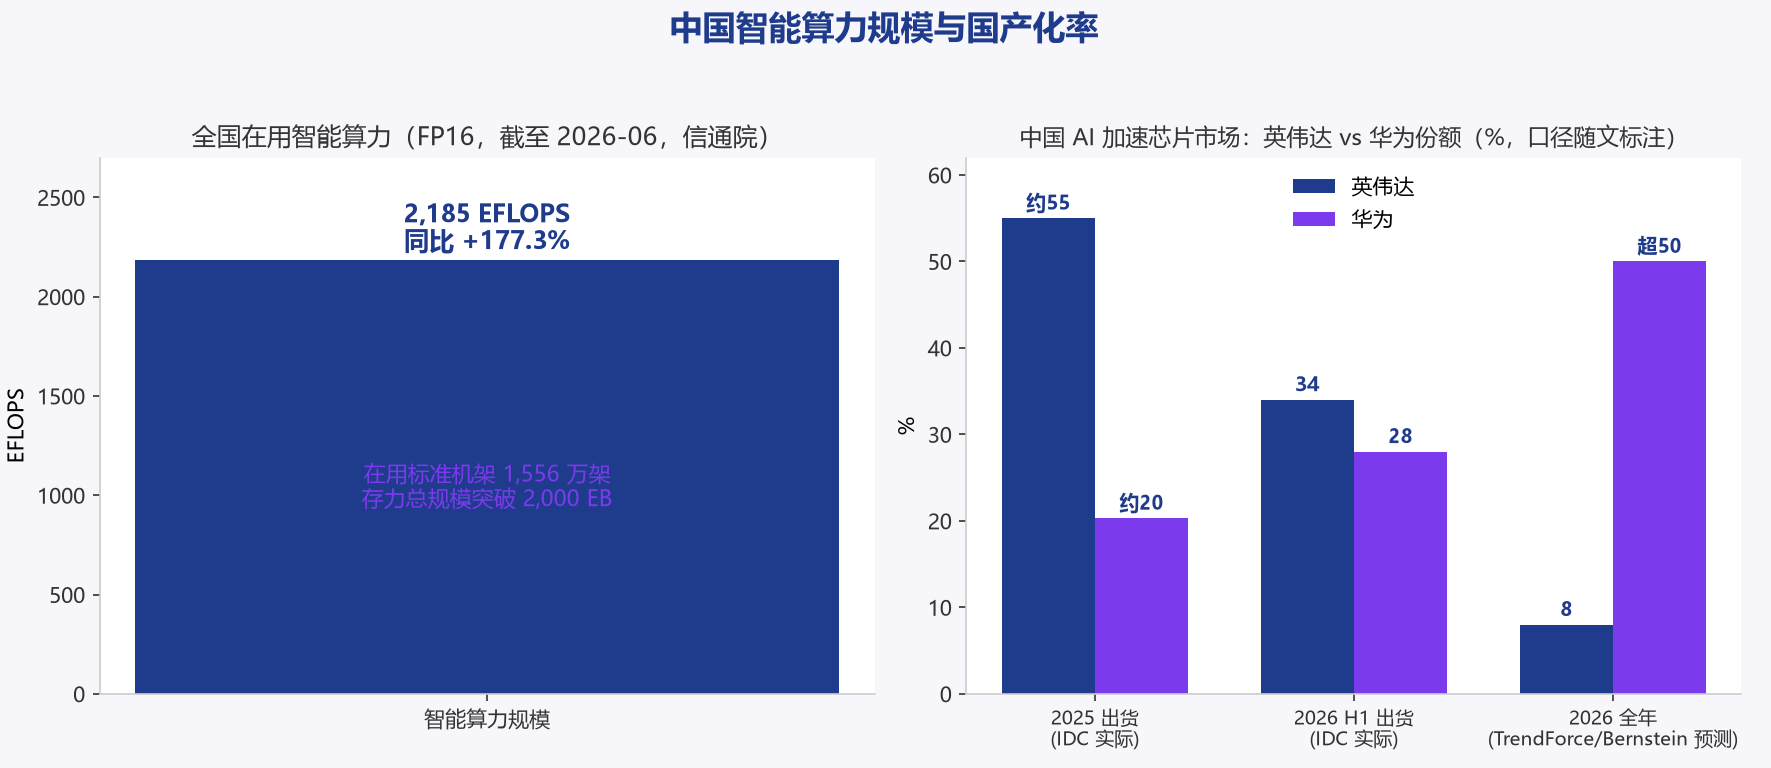
算力底座层面,中国信通院《2026 综合算力全景分析》显示,截至 2026 年 6 月底,全国在用智能算力规模达 2,185 EFLOPS(FP16),同比+177.3%;在用标准机架 1,556 万架,存力总规模突破 2,000 EB——增速在全球主要经济体中居于首位。
市场格局层面,机构预测呈现高度一致的替代方向:TrendForce 预计 2026 年中国高端 AI 芯片市场国产份额接近 90%(较 2025 年 12 月预测的约 50% 大幅上修),海外方案仅约一成;Bernstein 预测英伟达在华份额将从 2025 年约 40% 降至 2026 年约 8%,华为可能超 50%。需要强调口径区分:这是收入/高端市场的全年预测口径;而按 IDC 出货口径的实际值,2026 上半年英伟达在华 AI 加速器份额仍为 34%(出货 67.8 万颗,同比-44%),华为 28%(57.2 万颗),阿里平头哥 7%、寒武纪 5%、百度昆仑芯 4%、海光 3%,总出货 200.8 万颗——其中非 GPU 加速器出货(101.6 万颗)首次超过 GPU(99.1 万颗)。作为对照锚点,2025 年全年中国 AI 加速卡总出货约 400 万张,国产厂商 165 万张、本土渗透率 41%(首次突破四成),其中华为昇腾 81.2 万张居首(IDC,2025 全年真实值)。
产业验证层面,寒武纪 2026 年上半年营收 59.96 亿元(+108.1%)、归母净利润 23.11 亿元(+122.6%)(寒武纪半年报);行业面上,中国半导体行业协会(CSIA)统计 2026 上半年设计、制造、封测三业合计销售额约 8,815 亿元(+34.9%),其中制造端增速 54.5% 首超设计与封测;上半年集成电路出口 1,772.8 亿美元(+96.1%)。
供给侧的核心变量是华为。2026 年 9 月 17 日全联接大会上,华为发布业界首个采用 NPO(近封装光学)技术的昇腾960 超节点,通过 UnifiedBus 互连与 Hi-ONE 光引擎最多连接 4,096 张加速卡,往返延迟低至 2 微秒,960DT 提前三个季度、将于 2027 年一季度就绪(华为全联接大会 2026)。华为轮值董事长徐直军在同期的全联接大会上表示,按华为自有数据,昇腾在中国 AI 芯片市场份额已超英伟达,制约昇腾放量的主要问题是供给能力而非需求。
对中国的算力产业链而言,Maia 300 的发布提供了三点可借鉴的启示:其一,自研替代节奏上,微软从 Maia 200 的"效率基线"到 Maia 300 的"推理主系统"用了不到两年,验证了"先承接内部推理负载、再逐代放大部署"的可行路径,华为昇腾与国内 ASIC 阵营正在同一路径上加速;其二,上游封装与 HBM 机遇上,CoWoS 缺口 20%→10% 的收窄过程与 HBM 三巨头产能售罄的状态,提示国产先进封装(含 NPO 等近封装光学方向)与 HBM 供应链是确定性最高的价值洼地;其三,推理侧分工逻辑上,微软把自研芯片定位为"推理主系统"而训练仍大量依赖英伟达,印证了"训练买、推理自研"的分层逻辑——对中国厂商而言,推理侧的国产替代阻力最小、经济性最易验证,是替代进程的天然突破口。
中国智能算力 177.3% 的增速、国产加速卡渗透率从 41% 到"接近 90%"的预测跃迁、以及寒武纪等厂商翻倍的营收,共同勾勒出一条与全球主线并行、但驱动逻辑迥异的产业链——供给约束倒逼替代,替代催生生态,生态反哺上游。
【图 5】中国智能算力规模与国产化率