近日,南方科技大学深港微电子学院2025 级本科生刘天佑作为共同第一作者参与的研究成果,被自然语言处理领域重要国际会议 EMNLP 2026 录用。论文题为“.tmu: A Low-Entropy Tree-Structured Representation for LLM-Assisted Scientific Writing”(《.tmu:面向大语言模型辅助科研写作的低熵树结构表示》),该研究围绕科研文档的表示方式,研究并评估了一种低熵树结构表示格式 .tmu,为大模型定位文档内容、合并不同风格的稿件和修复文档错误提供了新的实现路径。
随着大语言模型逐步参与论文撰写、公式补全和稿件修订,科研写作正在从单次文本生成走向包含编辑、检查和纠错的连续工作流程。LaTeX 在数学排版和学术出版中得到广泛应用,但模型处理其源文件时,往往需要从宏命令和排版指令中重新推断章节、公式及引用关系;局部语法错误还可能在后续编译环节才被报告,增加定位与修复的难度。这些问题使文档表示方式成为影响大模型写作效率与可靠性的一个重要因素。
针对上述问题,研究团队基于GNU TeXmacs 的树结构技术基础,将 .tmu 作为面向大模型的科研文档表示进行研究。该格式将章节、公式、引用等内容组织为具有明确边界的树节点,使模型能够围绕具体节点定位和修改内容。例如,一个分数可以表示为包含分子与分母的独立节点,复杂公式则由多个节点逐层组合。这种组织方式为局部编辑、结构检查和错误定位提供了直接依据。
研究还关注同一内容的多种等价编码所带来的学习负担。在LaTeX 中,同一个公式可能存在多种显示结果相同的写法;.tmu 则通过更规范的树结构减少这类编码差异。论文将这一特征称为“低熵”,旨在减少模型预测后续内容时面对的不必要选择,为模型学习科研文档结构提供更简洁的表示。
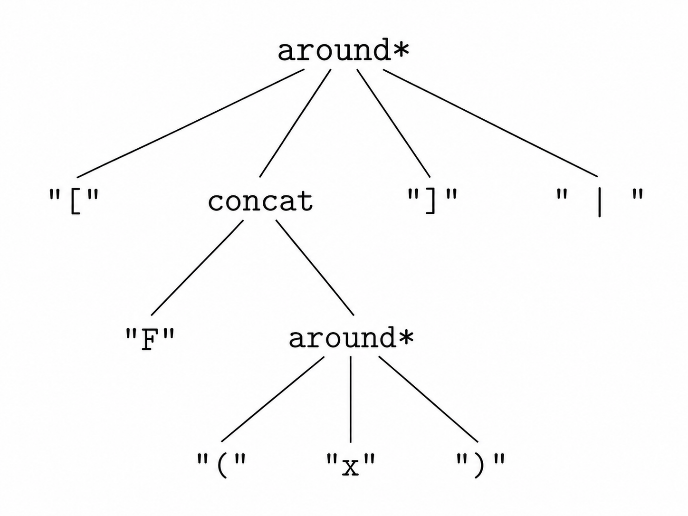
图1:.tmu 的树结构表示示意。公式由具有明确边界的节点组成,为模型理解结构和进行局部编辑提供支持。
为评估这一表示方式在实际任务中的表现,研究团队选取Deepseek-v3.2、Claude-Sonnet-4.5、Gemini-3-pro 和 ChatGPT-5.2 四个大语言模型,开展文档结构定位、不同风格文档合并和错误修复三类实验。研究采用兼顾任务完成情况与 token 开销的任务效用评分,对两种格式及其原生工具流程进行比较。
实验结果表明,在所评估设置下,.tmu 在文档合并和错误修复两类任务中均取得了更高评分。其中,四个模型的文档合并评分分别由 57、77、84 和 71 提高至 92、98、96 和 95;错误修复评分分别由 88、87、96 和 78 提高至 98、100、100 和 98。在文档结构定位任务中,四个模型中的三个使用 .tmu 获得了更高评分。这些结果表明,显式结构与清晰的上下文边界,有助于改善大模型处理复杂科研文档的任务表现。
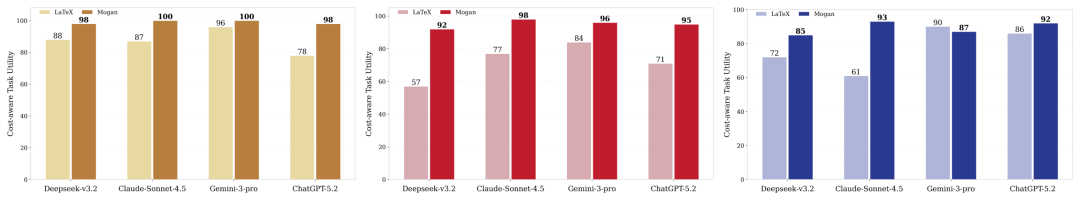
图2:四个大语言模型在文档结构定位、文档合并和错误修复任务中的表现。纵轴为综合考虑任务完成情况与 token 开销的任务效用评分,不代表正确率。
在模型训练方面,研究团队进一步基于Qwen2.5-7B-Instruct,使用 1000 个数学公式开展公式补全微调实验。在相同 LoRA 配置下,采用 .tmu 表示的最终训练损失约为 0.4,采用 LaTeX 表示时约为 0.7,前者降低约 43%。这一结果为减少等价编码冗余有助于模型学习提供了初步实验依据;其对下游生成质量的影响仍需进一步验证。
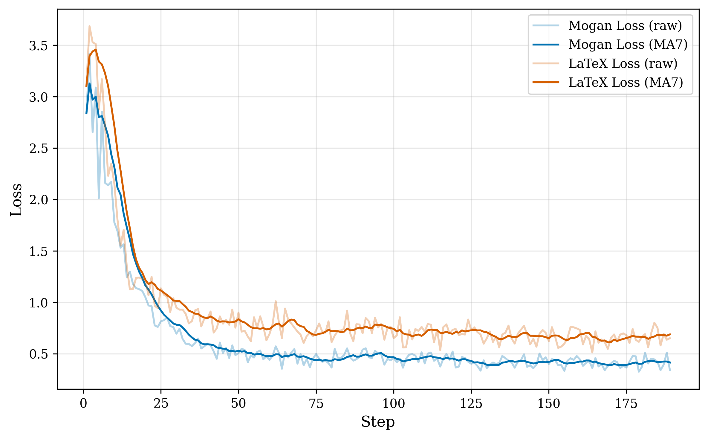
图3:采用 .tmu 与 LaTeX 公式表示进行 LoRA 微调时的训练损失曲线
该研究从科研文档的数据表示出发,为大模型辅助写作工具的设计提供了新的思路。将显式文档结构与模型处理流程相结合,有望改善科研写作中内容定位、稿件整合与错误修复的效率和可靠性,为人机协同科研写作提供基础支持。后续研究将进一步扩大评测规模,并验证不同模型和文档类型下的适用性。
南方科技大学深港微电子学院 2025 级本科生刘天佑与南方科技大学计算机系毕业生李子强为论文共同第一作者。该研究在宁波东方理工大学副研究员李岩松指导下开展,李岩松为论文通讯作者。