从2024年5月企业成立到2026年10月正式量产交付,东方算芯仅用24个月完成了DF1000算力芯片研发、全栈软件适配与大规模训练集群交付的完整闭环,成为全球首个实现3D大算力芯片集群商用部署的企业。这家植根于清华大学集成电路学院的上海芯片公司,在14nm成熟工艺节点下跑出520TFLOPS@BF16算力,用"软件定义+3D堆叠近存计算"的架构路线,绕开了对先进制程与高端HBM的依赖,为国产算力产业化提供了一条低投入、快落地、可复制的新路径。
交付提速:三个月走完发布到商用
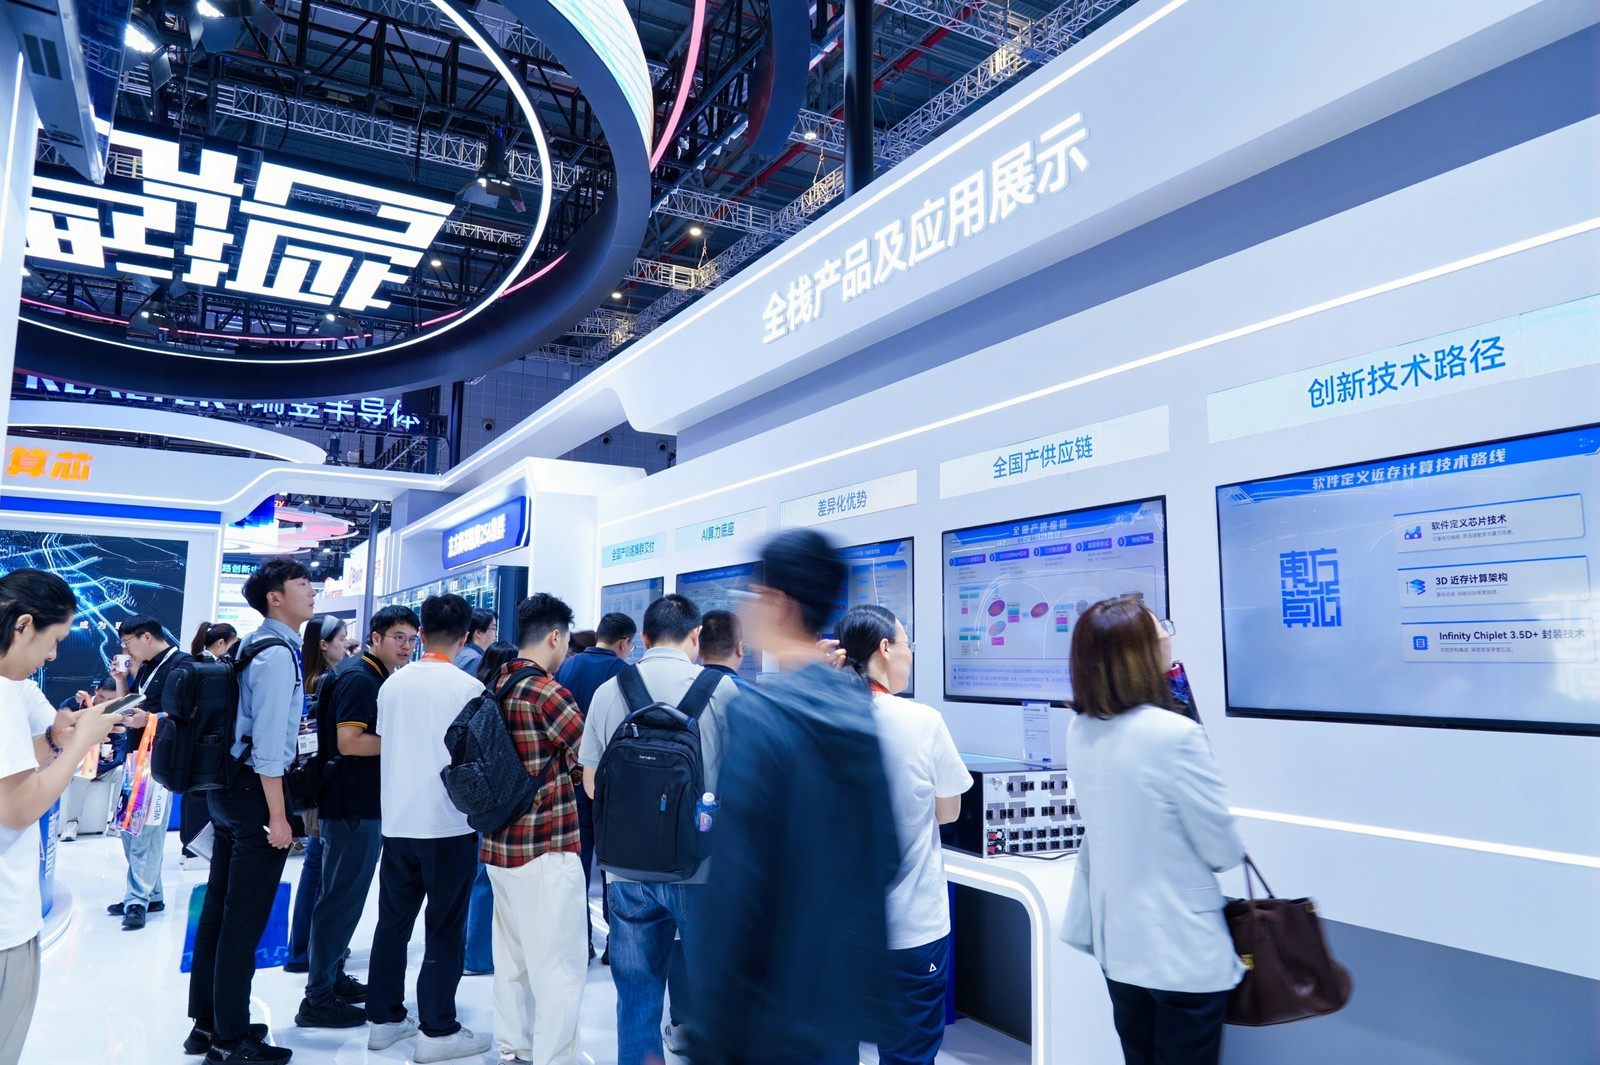
10月的上海国芯展上,东方算芯的展台比三个月前更热闹。
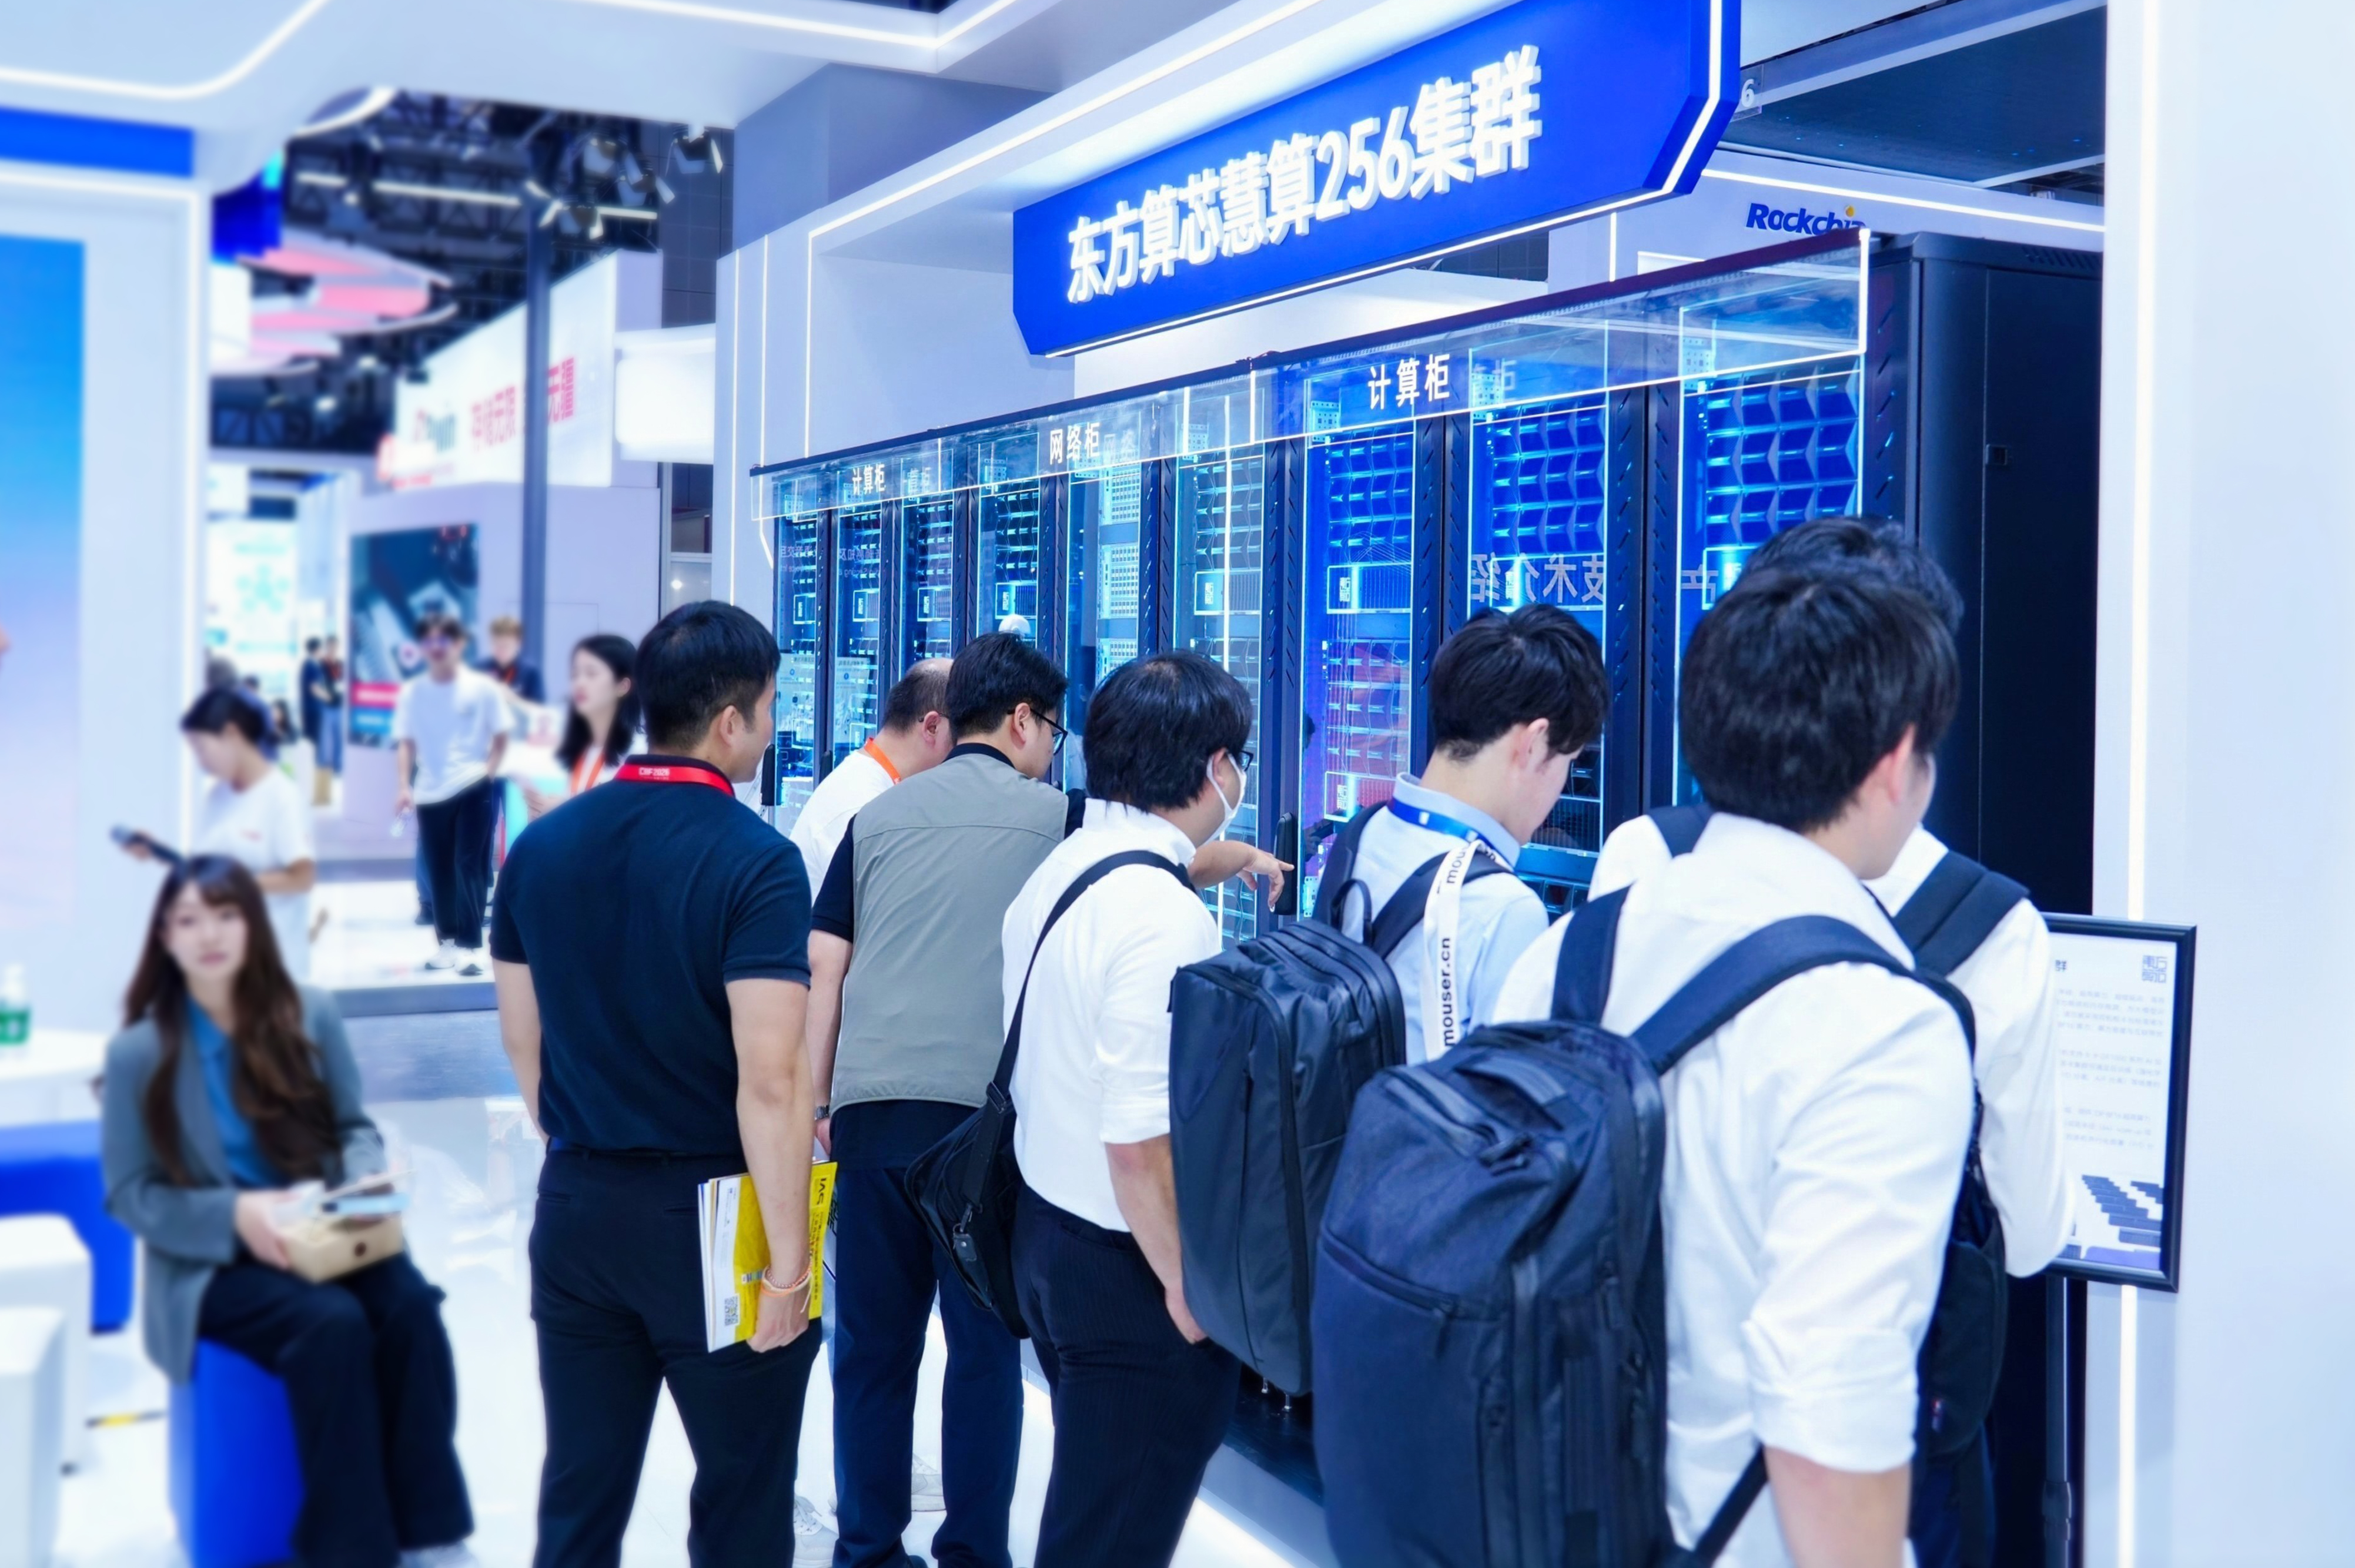
7月WAIC期间,这家成立仅两年多的公司首次对外发布DF1000芯片及从加速卡到集群的全产品矩阵。彼时外界关注的焦点,是这颗芯片能否在14nm工艺下真正跑起来。
三个月后,东方算芯给出的回答是:已经向首个客户交付了一套全国产大规模训练集群,并且年底将实现千卡级集群交付。
“7天完成主流大模型训练适配,128卡集群系统稳定运行,已实现大规模训练集群交付,年底实现千卡级集群交付。这是全球首次3D大算力芯片的全国产训练集群部署。”东方算芯副总裁郭炜在展会上透露,首批集群已经在客户侧承载实际训练任务,72小时连续训练稳定无中断,训练精度达到商用级要求。
这不是一次简单的展品迭代。从芯片流片、全栈软件开发,到64卡超节点互联设计、128卡集群调度系统搭建,再到大模型适配与客户验收,东方算芯把传统产业路线中往往需要三到四年的串行周期,压缩进了24个月。
东方算芯在现场展示了更具体的成果:11项BF16算子测试一次性全部通过;主流大模型训练适配仅用7天完成,其中包括千亿参数级别的Step 130B模型;集群从基建适调至具备训练能力,形成了标准化的“部署—联调—压测—试训—验收”交付流程。
资本的背书也在加速累积。公开信息显示,东方算芯2024年7月天使轮即获得张江高科、上海集成电路产业投资基金、高瓴、力合等机构入场;2025年年中引入国家人工智能产业基金、上海国投先导、锦秋基金;2026年2月A+轮融资又吸纳了云峰基金、招银国际、成都高新等产业资本,美团、小米、滴滴旗下基金亦在股东名单中。今年2月A+轮融资后,投后估值达122.75亿元,9月,公司完成股份制改造,变更为股份有限公司,并计划于四季度启动B轮融资。
从国有产业基金到互联网大厂系资本,股东结构折射出市场对"成熟制程+3D封装"路线的双重押注,既押注其技术可行性,也押注其供应链的确定性。
研发并行:打破串行迭代旧节奏
24个月跑通全链路,效率从何而来?
传统国产算力芯片的研发路径,大体是一条串行链,即先完成芯片流片,再交由软件团队做算子与编译器适配,随后系统厂商基于芯片搭建板卡与服务器,最后集成为集群。每一个环节的迭代都依赖上一环节的交付,跨厂商沟通成本高、责任边界模糊,往往一颗芯片从流片到能跑大模型,就要消耗一到两年。
东方算芯选择了另一种组织方式,芯片设计、编译器与算子库开发、集群系统架构三大板块从项目立项起并行推进、协同验证。这意味着硬件团队在画版图的同时,软件团队已经在仿真环境上做算子优化,集群团队同步定义超节点互联拓扑与调度协议。
“前端研发、供应链、工程交付、客户验证全环节高效协同,减少跨部门沟通损耗。”郭炜介绍,公司总部在上海张江,约400人,另在北京、南京、西安、成都、苏州、深圳设有研发分部,就近匹配供应链与客户资源。
这种并行模式的底气,来自统一技术栈。从芯片架构到编译器、算子库、集合通信库、分布式训练框架,再到集群调度与运维工具,东方算芯全部自研。当芯片、软件、集群出自同一支团队,每一代迭代都不需要跨厂商重新适配,上一代积累的算子优化与调度策略可以直接复用到下一代产品。
团队精干:五百人撑起全栈闭环
精干,是东方算芯团队的另一个关键词。
目前公司总人数550余人,其中近九成为研发技术人员。在国内AI芯片设计公司中,这一规模已属中大型。然而,要知道做一颗旗舰GPU并支撑万卡集群运营,国内外头部厂商动辄需要数千甚至上万人。
但就是这样一支团队,不仅完成了全栈技术闭环,还在客户侧支撑着128卡集群的日常稳定运行。
集群搭载了智能调度、故障自愈与全维度监控体系,大部分异常可以在无人工干预的情况下自动恢复。运维团队不需要逐卡排查问题,系统层面统一调度算力、显存与通信资源。"低人力成本实现高可靠集群运营",这是郭炜在采访中反复强调的一点。
首批客户的反馈也验证了这一模式。据介绍,试点客户对集群稳定性、训练效率和服务响应速度均给出正面评价,方案可快速复制适配不同规模的算力需求。不过东方算芯目前仍未披露客户名称——其直接对接的是智算云与应用云厂商,由后者面向终端行业客户消纳算力。
550人的团队规模并未让公司感到轻松。“时间紧任务重,各个部门都在叫苦不迭,还是要加人。”郭炜坦言,目前一代产品进入量产交付期、二代产品研发同步推进,人才缺口仍在扩大。
架构破局:成熟工艺跑出高端算力
集群能在128卡规模上稳定跑通大模型训练,底层支撑是DF1000的架构创新。
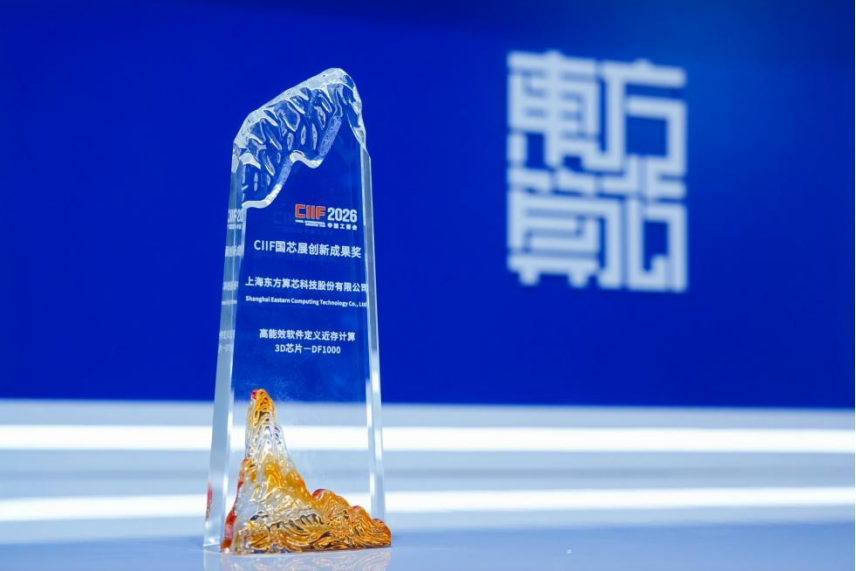
DF1000采用“软件定义+3D堆叠近存计算”技术路线,在14nm成熟制程下实现520 TFLOPS BF16算力、6.4TB/s访存带宽,卡间Scale-up互联带宽900GB/s。其核心思路是通过3D混合键合技术将计算层与存储层垂直堆叠,将互连间距压缩至亚微米级别,从根本上缩短数据传输路径。作为参照,国际头部厂商的旗舰训练芯片普遍采用4nm级先进制程、CoWoS封装与HBM3高带宽存储。
在先进制程受限的背景下,国产算力公司长期面临一道两难命题,要么追逐最先进制程但供应链不可控,要么退而求其次但性能差距悬殊。东方算芯选择了第三条路——不在制程上硬碰硬,而是从架构层面把数据搬运的效率做上去。
具体做法是3D近存堆叠。DF1000是国内首颗采用DRAM-Logic晶圆级混合键合3D垂直封装的AI芯片,结构上为在逻辑芯片上,堆叠多层存储芯片。通过混合键合技术,逻辑晶圆与DRAM晶圆在晶圆级别直接对准、键合,互连间距从传统封装的数十微米压缩至亚微米级,带来数量级提升的互连密度与带宽密度。
这与HBM有本质区别。HBM是把多层DRAM堆叠后贴在GPU旁边,逻辑芯片与存储芯片之间仍有较长的走线;DF1000则是底层计算,上层存储,数据在垂直方向上流动,路径更短、时延更低、功耗更省。用东方算芯技术人员的话说,相当于在HBM下面直接贴了一颗逻辑芯片,但设计与制造工艺完全不同。
另一支柱是软件定义芯片。通过软硬件解耦与动态重构,同一套硬件资源可以根据不同算子的需求做空间并行与时分复用,提升利用率。这也是为什么在14nm这种成熟工艺下,仍能跑出对标国际高端产品的等效算力。
同构降本:统一技术栈摊薄迭代成本
架构创新带来的效率红利,不止于芯片本身。
传统异构算力集群中,芯片、基础软件、调度系统往往分属不同厂商。每一次制程升级或芯片迭代,都意味着跨架构的全链路重新适配——算子要重写、编译器要重调、调度策略要重新验证,人力投入巨大。而且异构硬件混合运行时,排错、调优、兼容性维护的工作量随集群规模线性增长。
东方算芯的全栈同构体系,从根源上改变了这一成本结构。芯片、软件、集群协同设计,统一技术栈,算子优化与调度系统可以跨代复用。这意味着计划今年四季度发布的二代产品DF2000算力有望提升至900—1000TFLOPS,显存容量更大,软件工具链在一代基础上继续打磨——不需要从零重建生态,而是在已验证的体系上做增量升级。
供应链层面,14nm成熟工艺与全国产DRAM配套,使DF1000不受海外先进制程管制与高端存储断供风险的制约。量产环节已由国内制造合作伙伴完成,从芯片到整机的交付周期可控,产能扩张不依赖海外封装产能。
这也是魏少军反复强调的判断,国产算力不能永远跟在先进制程后面追赶,必须找到一条不依赖EUV、不依赖HBM、但性能与可持续性都站得住的路线。
规模复制:从百卡集群走向千卡
东方算芯的产业化节奏,恰逢国产算力需求的结构性扩张期。
2026年被行业视为国产超节点方案的加速发展之年。据第三方机构IDC数据,2026年一季度中国AI芯片市场规模同比增长87.2%,国产AI芯片份额首次突破55%,在政务、金融、能源等关键行业领域,国产AI芯片采购占比已超70%。全国一体化算力网络建设的推进,也在加速国产技术验证与规模化落地。
站在大规模训练集群交付的节点上,等在东方算芯面前的是更大规模的市场验证。
目前,产品矩阵已经铺好,巅峯DF1000加速卡遵循OAM2.0规范,适配主流服务器平台;擎元QY100为单机8卡AI服务器,提供风冷与液冷两种版本;拓域TY64为64卡液冷超节点,单节点算力达33PFLOPS;慧算HS128则是面向大规模数据并行训练的128卡集群方案。从现场展示看,超节点内部采用铜互联,超节点之间通过光互联扩展,集群规模可从128卡平滑扩展至256卡、512卡乃至千卡级,可根据客户需求灵活扩展。与之配套的是自研全栈CAAP软件栈,覆盖编译器、算子库与集群管理,官方称其可兼容数千片加速器——低人力密度与全栈闭环,正是这家公司"用更少的人做更可靠的系统"的底座。
客户结构上,东方算芯定位为“算力底座提供者”,直接服务智算云厂商,间接覆盖互联网、金融、科研、医疗、政务等场景。公司计划优先向上海本地的企业、高校与研究所供货,再逐步向全国推广。
产品路线图也已清晰,量产一代、研发一代、预研一代。DF2000定于2026年四季度发布,三代产品也已立项。
结语
回顾东方算芯24个月的全栈落地,其意义或许超出单个公司的成长故事。
传统算力产业的竞争逻辑是“制程领先者通吃”——谁掌握了更先进的制程,谁就拥有更高的性能和更低的功耗。这条规则下,追赶者的窗口期越来越窄。东方算芯的实践指向另一种可能:通过架构创新、软硬协同和全栈自研,在成熟制程条件下实现有竞争力的算力输出,同时依托国产供应链保障产能扩张的确定性。
24个月跑通全链路,对一家2024年中才成立的公司而言,是效率的证明,更是路线的验证。但东方算芯真正要回答的问题才刚刚开始——当集群走向千卡级、当成熟制程架构的性能天花板遭遇更复杂的大模型训练需求、当更多国产算力路线同台竞争,"近存计算"能否持续兑现它在效率与成本上的承诺。
这条绕开制程弯道的新路径,接下来才是真正的大考。