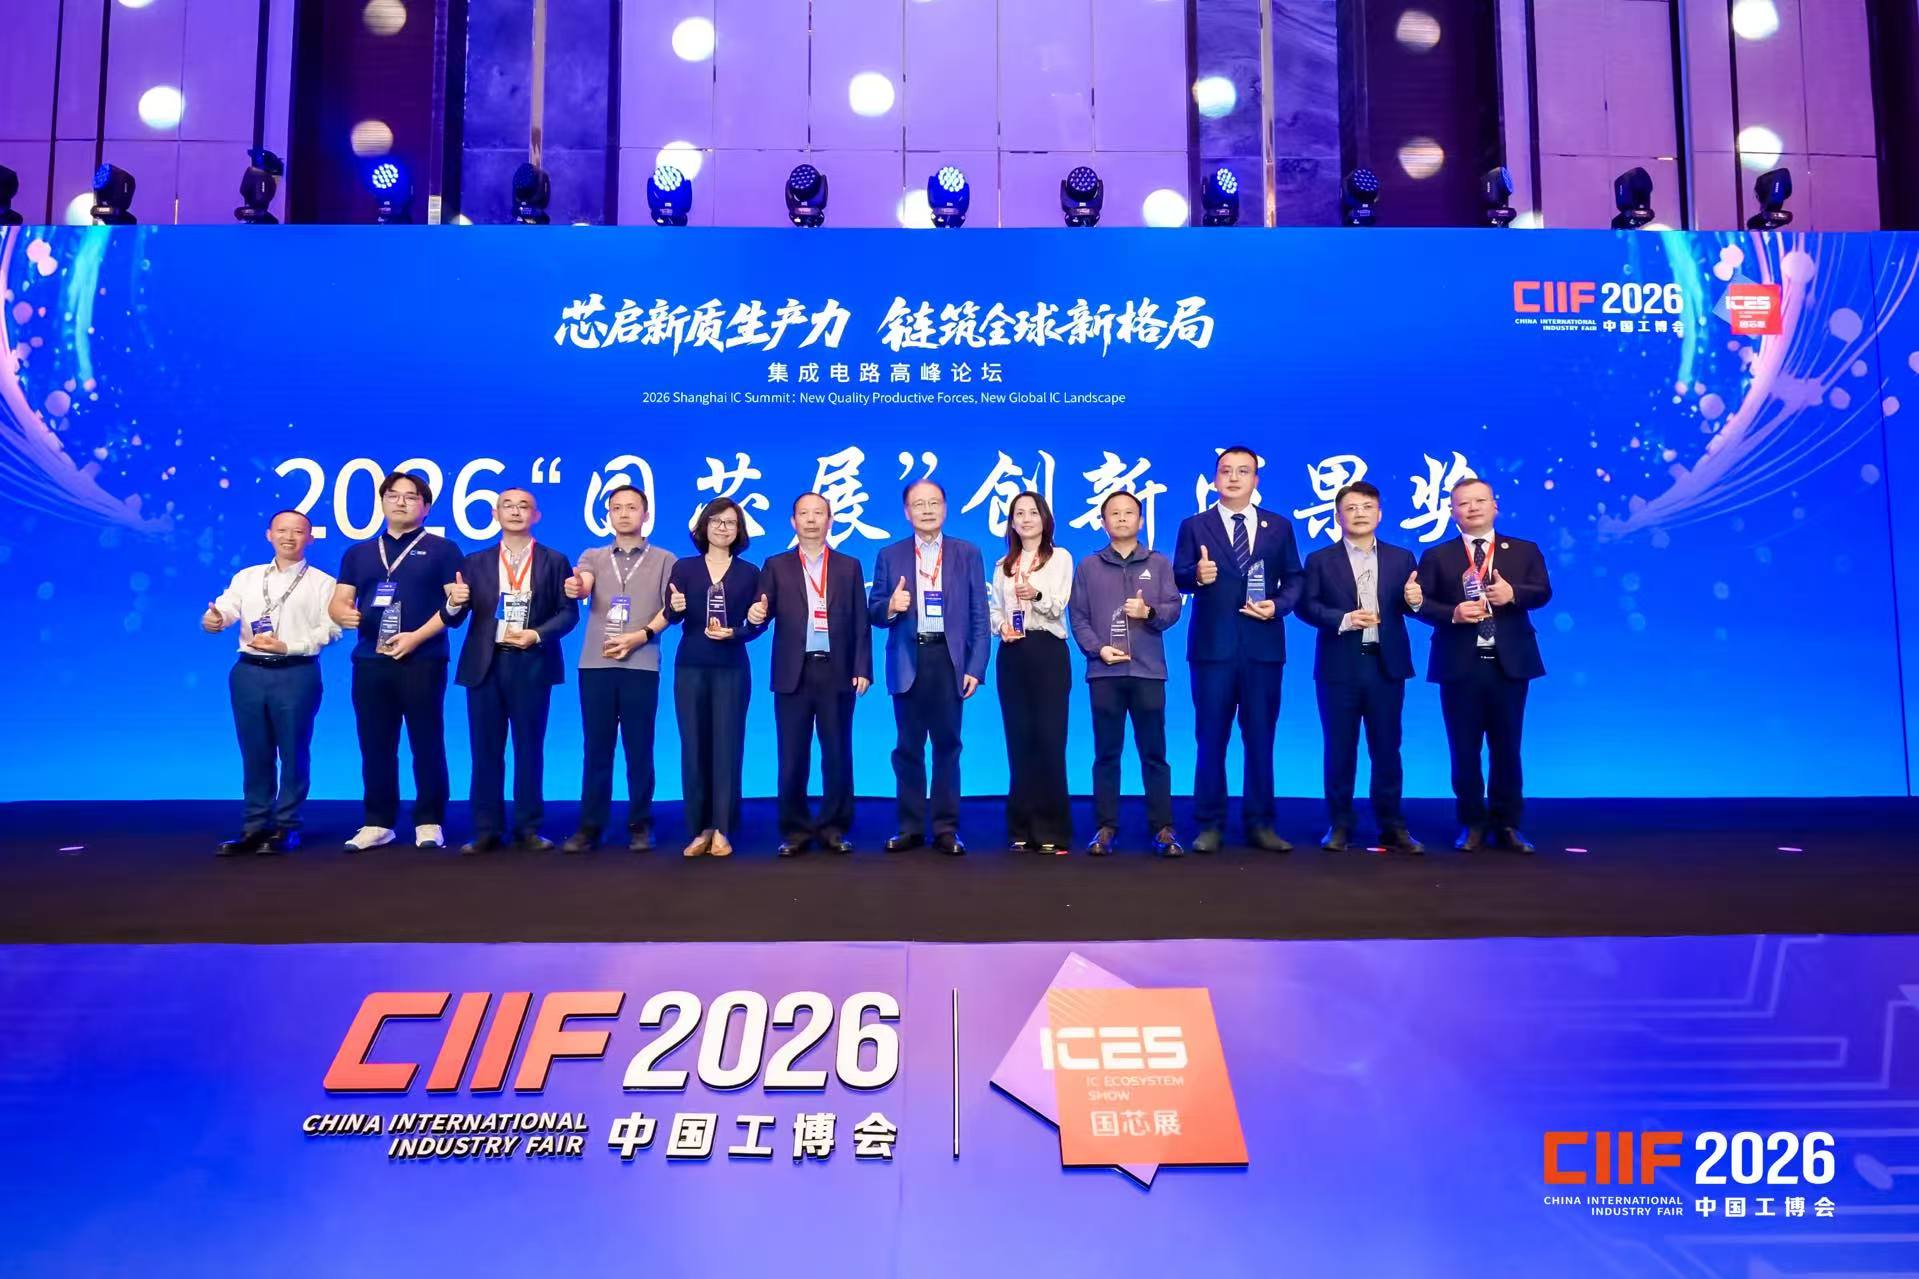
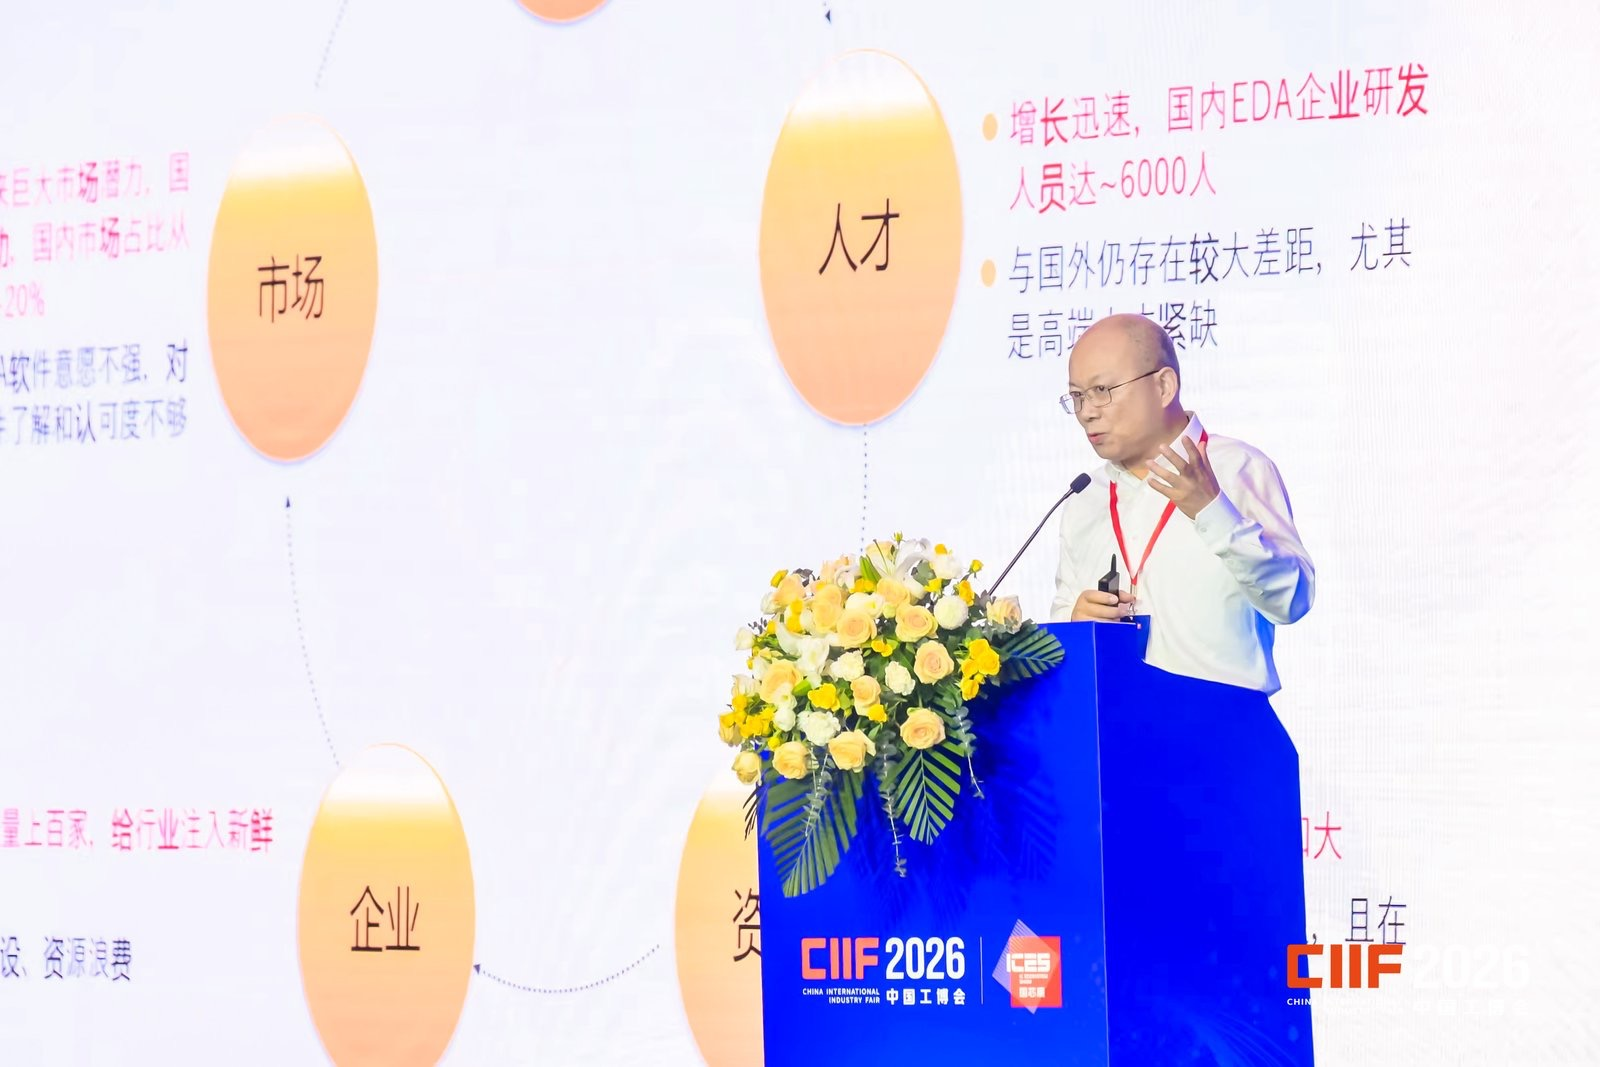
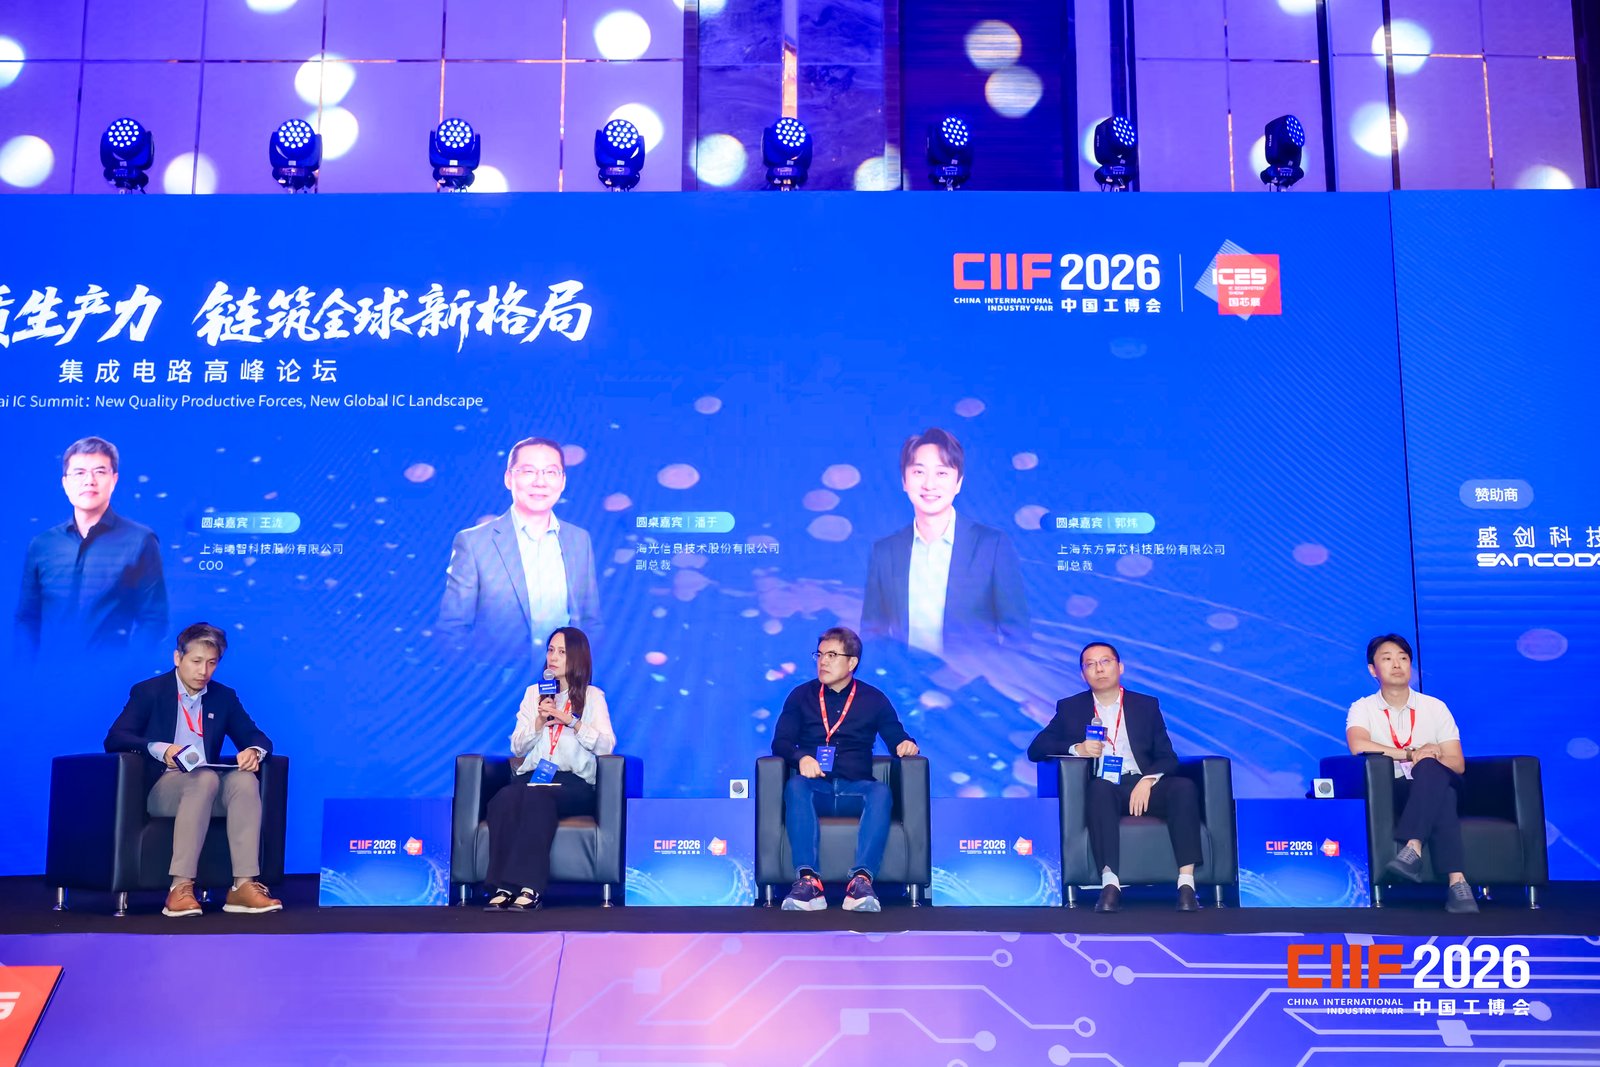
10月12日,第26届中国国际工业博览会在上海开幕。作为本届工博会全新升级的独立专业展,集成电路展(“国芯展”)以“芯链工业,强芯筑基”为主题举办。当天下午,“芯启新质生产力,链筑全球新格局”集成电路高峰论坛同步举行。圆桌讨论围绕大模型时代的“算力拼图”:本土GPU如何从“单卡性能”走向“集群协同”展开。
本场圆桌由概伦电子首席科学家余备主持,沐曦集成电路CTO彭莉、上海曦智科技COO王泷、海光信息副总裁潘于、东方算芯副总裁郭炜共同参与。论坛设置六大议题,从内存墙、三维集成、互联演进、功耗能效,一路延伸至标准生态与大芯片设计工具链。与会嘉宾一致认为,AI算力的竞争,已经从单颗芯片的峰值指标,转向存储、互联、封装、功耗、生态全链路的系统设计能力;本土GPU的破局点,不在单点突围,而在产业链协同。
内存墙:真正贵的不是计算,是搬运
大模型推理的成本结构正在发生根本性变化。当模型参数从百亿冲向万亿、上下文窗口从数千token拉到数十万,数据搬运量呈指数级膨胀,而存储带宽的提升速度远远落后于算力增长——这就是业界热议的“内存墙”。
沐曦集成电路CTO彭莉从架构视角给出判断。她认为,当前算力芯片面临的挑战并非单一维度,而是算力、带宽、互联在PPA(性能、功耗、面积)目标下的系统平衡。“模型迭代太快,算法没有定型,大家都在追逐在最好硬件上榨出最大性能。”彭莉以汽车产业比喻到,传统燃油车时代,大排量高性能车型价格昂贵;新能源车起来之后,比亚迪在高性价比区间走出了自己的路。“产业发展到一定阶段,一定要面对成本和性价比的大幅提升。”
她认为,打破内存墙,必须软硬件协同作战。软件侧通过算子融合、量化、稀疏化等手段降低对存储的需求;硬件侧则在不同计算阶段探索差异化的内存架构——Prefill与Decode分离、1.5bit参数与完整精度动态切换,都是在不同阶段匹配不同存储介质。“从上到下、从下到上一起去打破内存墙。”
3D集成:连起来不难,保良率才难
如果说内存墙是“数据太远”,三维集成(3D IC)就是用物理折叠把距离压到微米级。HBM是3D推理的第一代产物,而更先进的3D封装正在把逻辑芯片与存储层叠合。但圆桌嘉宾们一致指出,3D集成真正的难点不在“连起来”,而在“连起来之后能不能保证良率和散热”。
东方算芯副总裁郭炜直言不讳。他介绍,东方算芯第一代产品DF1000走的就是3D集成路线,互联线间距大幅缩小,2.5D方案已经成熟,但3D路线带来了新问题——层间热密度飙升、热-力-电多物理场耦合,任何一层的缺陷都可能导致整个封装报废。“一个封装价值越高,良率损失的代价就越惨重。”
更现实的缺口在于工具链。郭炜透露,目前行业在3D良率预测和热管理仿真方面仍缺乏端到端的精准工具。“二维产品在32纳米标准下良率是确定的,但3D封装我们只能保证两位数的良率,前期设计阶段对热点的精准预测工具还不够。”他强调,3D集成不能只看芯片本身,必须从芯片、封装、控制、软件、算法到机房系统做全链路优化。通过架构创新和封装创新,东方算芯实测能效提升了50%—80%,“但这改变不了工艺的现状,晶体管开关的物理极限我们突破不了”。
作为下游用户,海光信息副总裁潘于从需求侧给出了三个朴素的期待。他说,海光的CPU和DCU对先进封装有大量实际需求,最关心三件事:“第一,设计完能过关,要按统一标准验收;第二,跑得快,从设计到交付要按时;第三,成本对得上——客户要能感受到3D不是为了堆叠而堆叠,而是真正解决了设计问题。”
光电融合:光互联先落地,光计算待拐点
3D集成解决的是封装内部的距离,封装之外——芯片之间、机柜之间、集群之间——靠的是互联。电互联经过几十年演进,在带宽密度、传输距离和功耗上正逼近物理极限。一个普遍判断是:光互联将在未来几年从机柜级下沉到封装级。
曦智科技COO王泷对此有清晰的产业化节奏判断。他认为,光计算并不意味着取代硅基计算,而是通过光电融合和光互联,把芯片内数据搬运的成本降下来。“光互联会先于光计算产业化。”他给出的依据是,2026年,1.6T的可插拔光模块已进入商业配置,3.2T的技术路线正在认证;上个月阿里发布的3.2T到6.4T的NPO芯片,曦智已经开始送样验证,“它明显缩短了高速电信号的距离,带宽提升很显著”。
但王泷也泼了冷水。他说,光计算目前仍然昂贵,真正走向产业化还需要架构拐点——不是单纯扩大光矩阵,而是把光计算、光互联、3D存储、Chiplet异构融合在一起:“用电计算负责精度控制,用光负责大尺寸运算,用3D存储做物理处理,用OIO实现Scale-out网络扩展。”他透露,基于这种异构融合架构的产品,预计明年会有进展。
潘于从应用侧补充了光电融合的边界。他观察到,光正在从机柜外向机柜内、从板级向芯片级渗透,原因是单机柜功率密度越来越大,电信号传输距离逼近极限。“但光不是完美的——用了光就需要激光器、光源,这些都要从整体系统管理角度看。”他的判断是,电和光会在很长时间内耦合在一起,追求的是性价比最优,而不是谁取代谁。
生态路线:开源为矛,自主为盾
英伟达用NVLink构建了一个从互联协议、超节点到软件栈的封闭生态;另一边,以UCXL为代表的开放标准正在快速迭代,最新版本已开始支持光互联和缓存一致性。对国产算力产业而言,这是一道选择题:跟随开放标准融入全球生态,还是自定义协议把主动权握在自己手里?
潘于的回答坦率而务实。他说,这个问题“非常难”,不同企业在不同阶段会有不同选择。在当前国际环境下,协议层面必须做到自主可控,“但自主可控不意味着技术落后,仅仅为了自主而自主是不对的”。他认为,企业最重要的是培养底层能力——在接口层、协议层自己能做创新,同时在软件侧持续迭代。海光自己的协议栈已经拍完,但也呼吁参与国际标准共建。“开源协议更重要的不只是协议本身,而是要争取上下游的支持。”
彭莉则用了一个极具画面感的比喻。她说,中国AI算力生态目前还处于“战国时代”,如果要走向“秦统一”,统一的是度量衡、文字和语言——“开源对我们这个阶段来说,是正确且要优先解决的道路。”她解释,AI计算是一场技术范式的剧变,在快速变化期,生态碎片化会严重拖累效率。沐曦从2024年起将开源生态列为战略级工作,分两个层次推进,一是把MXMACA软件架构逐步开源,面向社区做大规模开源、面向合作伙伴做更细腻的开放;二是通过高校和开发者社区活动,培养并行计算生态的人才。“我们会给高校和开源社区提供免费的算力支持。”
系统竞争:单卡时代落幕,集群协同开场
圆桌最后,余备把话题收束到EDA工具链。当一颗大芯片同时要设计逻辑、存储、光电和3D集成,传统的单点工具已经不足以支撑架构探索。他呼吁国产EDA工具不仅要跟上,更要用AI的方式重构设计流程。
潘于从从业者角度分享了一个观察。他说,EDA公司和设计企业的关系正在变得前所未有的紧密——“从工具到产线到设计,三家公司像绑在一起一样不停陪伴、共同迭代。”这种紧密协同,正是3D集成时代设计制造协同的缩影。
近两个小时的讨论,从内存墙到3D封装,从光电融合到生态标准,五条线索最终汇向同一个结论。余备在总结时强调,AI算力的竞争,已经从单颗芯片的算力性能指标,走向整个系统的设计能力提升。单个企业解不开系统性的难题,产业链的答案只能在产业链内部寻找。而本土GPU的下一程,考验的不只是芯片本身,而是内存、互联、封装、软件、生态与制造协同的综合能力。谁能率先拼齐这块“算力拼图”,谁就更有机会在大模型时代掌握主动权。