摘要
1. 真武V900性能较M890提升三倍,本质上是静态性能口径,客户真正感知的是端到端性能和TCO收益。更值得关注的是,平头哥正把AI芯片竞争从单卡跑分,推向系统级战争;
2. 真武V900从原定明年Q3量产提前至Q1,平头哥副总裁高慧直言“客户等不起,我们也不能等”,提前量产背后,是国内算力供不应求与阿里云工程化能力的双重推动;
3. 未来决定大模型上限的,不是一颗芯片有多强,而是一整套集群能不能像一台“超级计算机”那样工作;与此同时,软件生态正在成为量产之后的胜负手,变得前所未有地重要。
三倍性能是明线,万亿参数是底线
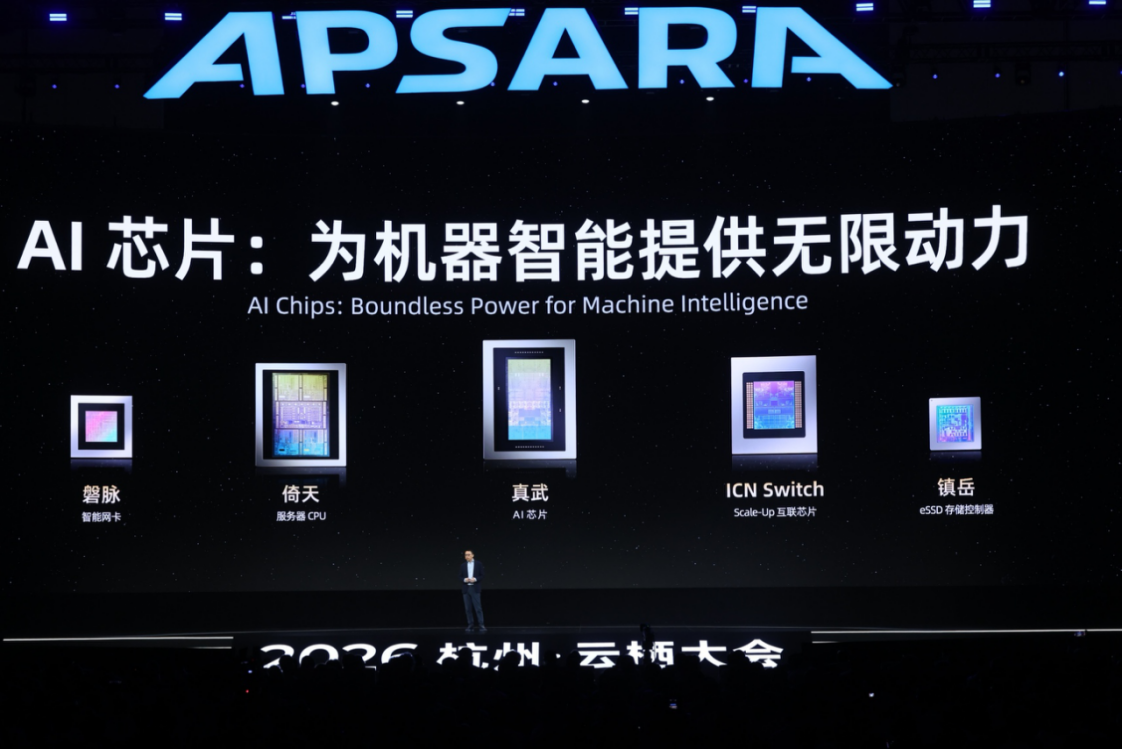
9月22日,2026杭州云栖大会上,平头哥发布新一代训推一体AI芯片真武V900。按发布会口径,这是当前中国自研AI芯片中算力性能最强的一款,单芯片性能达到真武M890的三倍,能够满足万亿级参数大模型的训练和推理需求,计划于2027年第一季度量产售卖。
如果只看“三倍”这个数字,很容易把它理解为一次常规迭代。但真正有信息量的,是“训推一体”和“万亿级参数”这两个限定词。过去不少AI芯片在训练和推理之间各有侧重:训练芯片追求高精度、大带宽、强互联;推理芯片则更在意低延迟、低成本和能效。真武V900试图把两件事放在同一颗芯片上完成,这背后是对大模型产业节奏的判断:模型不会只在训练场里长大,它最终要进入推理场景,变成每天被调用无数次的服务。
对话中,平头哥软件生态资深总监陆生华就“三倍”给了一个更客户视角的解释:“看芯片发布,大家习惯讲静态性能,但静态性能对终端用户其实是无感的,像游戏里的‘武力值’。用户最关注的是实际场景里的端到端性能,比如大模型推理或其他AIGC应用,端到端性能比上一代提升多少,再除以付出的成本,算出TCO收益,这才是客户感知最深的指标。”
真武V900基于自研并行计算架构设计,搭载216GB大容量显存,片间互联带宽达到1200GB/s,原生支持FP8、FP4低精度计算。这几个参数放在一起看,才能理解它的定位。
显存容量决定“模型能不能放下”。万亿级参数模型不可能塞进一颗芯片,但单卡显存越大,张量并行、专家并行时每个节点承担的压力就越小,通信次数也可能越少。216GB显存,意味着它在面对超大模型时,不是只能做“小切片”,而是有资格承担更重的局部计算任务。
片间互联带宽决定“数据喂不喂得饱”。大模型训练最怕的不只是算力不够,还有芯片之间的带宽数据。1200GB/s的片间互联,目标是让多颗芯片之间的数据交换尽量不成为瓶颈。芯片再强,如果互联像早高峰“塞车”,算力也会被浪费。
按照时间表,真武V900计划2027年第一季度量产售卖。发布与量产之间有时间差,真正的考验在晶圆、封装、软件栈、客户迁移和规模化交付上。一颗芯片的胜利,从来不是发布会结束那一刻。
这也是真武V900提前“下山”的原因。陆生华说:“今天,整个AI生态发展非常迅速,需求爆发式增长,国内算力供不应求。V900内部已有样片在测试,正在经过软件端产品化过程。提前到一季度,本质上就是上云去服务终端客户。”他表示,从芯片到最终上云服务的过程很复杂,传统情况下,从芯片测试完备到真正服务器上架大概需要一年,现在阿里云服务器团队加快节奏推进,靠的是强大的工程化能力。
超节点与50万卡,单卡再强也怕“堵车”
如果说真武V900是心脏,那么平头哥在云栖大会上展示的,是一整套血液循环系统。
针对万亿级参数大模型的训练和推理场景,真武V900可以与平头哥自研网络、存储芯片实现系统级优化。通过自研ICN Switch互联芯片连接后的超节点,具备原生内存语义和内存统一编址能力,可实现千卡全带宽高速互联。换句话说,上千颗真武V900不再是一千颗各自为战的芯片,而能像一颗“超级芯片”一样协同工作,为超大参数模型提供高吞吐、低延迟、高并发的算力。
这句话听起来很技术,但翻译成产业语言就是:AI集群的竞争,已经从“单卡比武”变成“系统战争”。
过去谈AI芯片,大家习惯比峰值算力、比制程、比显存。可当模型规模冲到万亿参数,单卡性能再强,也要面对一个朴素问题:数据在芯片之间怎么跑?内存怎么统一?通信协议怎么减少开销?故障怎么隔离?任务怎么调度?如果这些问题解决不好,集群规模越大,浪费越大。
大会现场,阿里发布全新升级的超节点服务器,内置真武V900、ICN Switch、磐脉智能网卡及镇岳SSD主控芯片,实现算、存、网全栈系统级协同。通过阿里云全新设计的智算中心网络架构,单一集群可扩展至50万卡规模。这个数字非常夸张,但它真正想表达的不是“卡多”,而是“卡多之后还能高效协同”。
50万卡是什么概念?它不只是采购问题,更是电力、散热、网络拓扑、存储吞吐、故障恢复和软件调度的综合工程。一个集群如果只有算力芯片强,网络和存储跟不上,就像城市里全是跑车,但道路狭窄、红绿灯混乱、停车场不足,最后谁都快不起来。AI集群的效率,往往不取决于最快的那颗芯片,而取决于最慢的那段数据搬运。
平头哥的底气在于,它不是只做一颗AI芯片,而是把ICN Switch互联芯片、磐脉智能网卡、镇岳SSD主控芯片一起摆上桌。算力、网力、存力全栈自研,意味着接口、协议和优化可以更深地耦合,不必完全受制于通用方案。这种“自己定义规则”的能力,才是系统级竞争的关键。
据悉,基于真武M890的超节点已大规模应用,并跑通了Qwen3.8、KimiK3等超2万亿参数规模模型。这说明平头哥的真武系列不是停留在实验室样品阶段,而是在真实的大模型训练和推理场景中接受过检验。M890尚且如此,V900作为三倍性能的新一代产品,想象空间自然更大。
当然,系统级战争也有自己的残酷之处:客户买的不是一颗芯片,而是一整套迁移成本、软件生态和运维体系。谁能让开发者少改代码、让集群少出故障、让推理成本肉眼可见地下降,谁才能笑到最后。真武V900的真正对手,不只是其他AI芯片,而是整个AI基础设施的效率天花板。
Agent倒逼CPU进化,平头哥全栈棋局
如果说真武V900和超节点解决的是“AI算力”问题,那么平头哥首次公布的倚天服务器CPU规划,解决的是另一个更容易被忽视、却越来越致命的问题——Agent时代的CPU瓶颈。
Agent产品正在爆发。它不像传统聊天机器人那样只负责生成文本,而是要任务规划、状态管理、工具调用、多轮反思、结果校验。这些环节极其依赖CPU;与此同时,海量数据的预处理、编排与吞吐也需要CPU完成。GPU再强,如果CPU调度慢、内存带宽低、与GPU耦合松散,Agent就会像一个聪明但手脚迟钝的“数字员工”:想法很多,动作很慢。
大会现场,平头哥首次公布倚天服务器CPU的规划:2027年将推出倚天720和倚天730两代服务器CPU。倚天720将实现单核性能、核密度与能效的全面提升;倚天730将首次基于平头哥全自研CPU微架构设计,单核SPECint2017/GHz性能最高提升至倚天710的1.4倍。未来几年,平头哥还将持续升级自研CPU微架构。基于第二代自研核的倚天750,将支持平头哥自研ICN片间互联总线协议,倚天CPU与真武AI芯片之间可通过ICN总线直接互联,进一步提升CPU与AI芯片的协同效率。
这段路线图的信息量很大。它说明平头哥不是把CPU当作配角,而是把它当作AI系统的“项目经理”。在Agent场景里,CPU负责拆解任务、调用工具、管理状态、编排数据流;AI芯片负责重负载计算。两者如果通过ICN总线直接互联,就能减少传统路径中的搬运和等待,形成合力。
目前,平头哥已推出真武系列AI芯片、倚天系列服务器CPU、ICN Switch互联芯片、磐脉系列智能网卡、镇岳系列存储主控芯片等数据中心核心芯片,实现算力、网力和存力的全栈自研,并实现全栈高效协同。这套组合拳的意义,不是“平头哥什么都有”,而是它可以在芯片、协议、系统、云平台之间做深度定制。对外,它是一家芯片公司;对内,它是阿里云AI基础设施的底座。
市场层面,真武系列芯片已服务超650家企业客户,覆盖智驾、金融、大模型、具身智能、能源、制造等千行百业,是场景应用最广的中国自研AI芯片之一。阿里巴巴集团CEO吴泳铭表示:“由于平头哥芯片产品线的成熟和客户的广泛应用,预计平头哥AI芯片的年出货量将大幅提升。”
“规模复制”大考,SAIL才是胜负手
650家企业客户,这意味着真武系列已经跨过了“有没有人用”的阶段,开始进入“能不能规模复制”的阶段。
按照之前的官方报道,平头哥真武系列芯片已有几十万片量级,这个量已经很大。从芯片到服务器,再到阿里云解决方案,以及上面的PaaS、SaaS层软件,其实都有应用。
但全栈自研并不等于高枕无忧。它面临的挑战同样清晰:软件生态是否足够友好?客户从原有平台迁移的成本有多高?量产交付能否跟上?50万卡集群的稳定性和能效能否经受真实业务考验?
但至少方向已经很清楚。真武V900不只是一颗“性能是M890三倍”的芯片,它是平头哥全栈棋局中的新心脏。而如果说真武V900、ICN Switch、磐脉、镇岳和倚天CPU构成平头哥的硬件全栈,那么SAIL软件栈就是把这些硬件真正变成客户生产力的操作系统层。
从迁移门槛角度,陆生华表示,现在很多开发者基于主流生态做应用开发,这些生态已经建立几十年,习惯根深蒂固。平头哥最大的有利点是,真武是GPU架构,整个开发和编程模式跟主流生态类似。开发者如果熟悉原有生态,迁移到T-Head SAIL上非常容易。
平头哥半导体软件技术资深总监毛钧则形象地将平头哥比作硬件厂商生产算力,阿里云像电网一样,用标准、高效的方式输送到用户侧;用户不用关心电怎么来的,打开开关灯就亮了。作为云模和硬件一体的厂商,好处是链路反馈非常短。很多时候模型算子选择很接近,但某些算子是不是在平头哥硬件上有更好表现?“这正是开放SAIL的重要原因,如果开发者能方便地做调整,甚至通过类似Skill的方式迭代、调整算法实现,就有可能在模型出来的那一刻,就在平头哥芯片上跑出非常好的performance。这样生态Win,用户也Win,是Win-Win!”
写在最后
中国AI芯片的下一战,不是谁的单卡跑分更高,而是谁能把成千上万颗芯片组织成一台“超级计算机”,让万亿参数模型训练得更快、推理得更便宜、Agent跑得更顺畅。从这个角度看,平头哥已经亮出了自己的全栈底牌,接下来要看的,是这张牌(真武V900)能否在2027年量产之后,真正打成一张改变产业格局的王牌。