一、参评规模创历史新高:30 家机构、两项新测试、最高 5.7 倍性能跃升
MLCommons 于 9 月 16 日发布行业基准 MLPerf Inference v6.1 结果:本轮参评机构达到 30 家,创下该基准诞生以来的历史新高,其中 Atlas Inference、Crusoe、Orrick Industries、ScitiX、VibeHPC 与个人贡献者 Naeem Khoshnevis 均为首次提交。据第三方评测媒体统计,本轮共产生覆盖数据中心与边缘侧的 486 项提交结果。
两项新增测试直接对应当前推理部署的演进方向。其一是面向数据中心的端到端 RAG(检索增强生成)基准:负载将问答任务拆解为向量化、检索、重排与大模型推理等多个环节,并分别测量语料入库与查询应答两类任务的性能;其二是边缘 Agentic Inference(智能体推理)基准:模拟多轮迭代、上下文持续增长的智能体编程类负载,引入时延指标与统计稳健的精度门槛。此外,v6.1 还在交互场景中新增了对投机解码(Speculative Decoding)这一生产环境常用优化的支持。
性能曲线同样陡峭:视觉语言模型(VLM)测试的最佳单加速卡服务器场景成绩较六个月前的 v6.0 提升 2.99 倍;DeepSeek-R1 测试的最佳单加速卡服务器场景成绩较一年前的 v5.1 提升 5.7 倍。本轮还出现了 MLPerf Inference 历史上规模最大的提交系统——512 张加速卡,以及两个新型异构系统:一个混合使用了两家厂商的加速器与高性能网络,另一个横跨太平洋实现地理分布式部署。
新硬件阵容亦为历轮之最:AMD Ryzen AI Max+ 395、AMD Instinct MI350P 与 Intel Arc Pro B70 均以可用状态提交,英伟达 Rubin 与 Vera Rubin NVL72 则以预览状态首次亮相[1]。MLCommons MLPerf Inference 工作组联席主席 Frank Han 表示:"有可信的度量数据,AI 社区再一次证明了可以被测量的才能够被改进。随着负载与系统在规模和复杂度上持续扩张,客户可以据此更好地理解成本收益权衡,做出采购与部署决策。"
基准本身的形态也在换代:超过 50% 的提交者采用了 MLPerf 全新的 API 中心化测试框架——它是下一代 MLPerf Endpoints 基准套件的基础。该框架采用真正的客户端/服务器架构,通过业界标准 API 传递推理请求与结果,更贴近真实数据中心的服务态部署;MLCommons 明确表示,MLPerf Endpoints 未来将取代 Inference 成为面向数据中心场景的基准。
二、Vera Rubin NVL72 首秀:Qwen3-VL 吞吐最高达 GB300 NVL72 的 3.7 倍
本轮最受关注的成绩来自英伟达下一代平台的首次预览提交。英伟达选择 v6.1 中要求最苛刻的两项负载——Qwen3-VL 与 DeepSeek-R1——对 Vera Rubin NVL72 进行了预览测试。在 Qwen3-VL 负载上,Vera Rubin NVL72 在离线(Offline)、服务器(Server)与交互(Interactive)三种场景下的吞吐最高达到现役旗舰 GB300 NVL72 的 3.7 倍(即较现役平台领先约 270%),软件栈采用 vLLM 与英伟达开源推理框架 Dynamo;在 DeepSeek-R1 负载上,基于 TensorRT-LLM 的吞吐最高达到 GB300 NVL72 的 2.5 倍(领先约 150%)。
英伟达将成绩归因于全栈协同设计:增强型 Tensor Core 与 Transformer Engine 同时加速预填充与解码两个阶段;NVFP4 低精度格式降低模型权重、注意力与 KV 缓存的显存占用,在几乎不损失输出质量的情况下抬升吞吐;提交中还大量使用了分离式服务(预填充与解码解耦)以及面向混合专家(MoE)层的大规模专家并行。在机架内部,第六代 NVLink 与 NVLink Switch 构成的 scale-up 域提供互联底座,官方称其数据包速率较现货以太网高 10 倍、时延低 3 倍。
从官方路线图口径看,这一代际跃升早有铺垫:下一代 Vera Rubin 平台的 NVFP4 推理算力达 3.6 EFLOPS,约为 GB300 NVL72 的 3.3 倍(提升约 230%);快速内存容量提升至 75TB,约为上代 1.6 倍(提升约 60%);NVLink 6 交换带宽提升至 260TB/s(提升 100%);配套 ConnectX-9 SuperNIC 带宽提升至 28.8TB/s(同样提升 100%)[8]。另据行业研报与发布会信息,Vera Rubin NVL72 还配备 54TB LPDDR5X 内存(约为上代 3 倍),HBM4 容量 20.7TB(1.5 倍)、带宽 1.6PB/s(2.8 倍),NVFP4 推理算力较上代 Blackwell 提升约 5 倍,同等训练任务所需系统规模约为 Blackwell 的 25%,单 token 成本可降至 Blackwell 的 10%。工程形态上,该系统单机柜功率突破 220kW,是英伟达首个 100% 全液冷散热的机柜系统。
量产与生态进度同步推进:英伟达已在 GTC 台北宣布 Vera Rubin 全面进入量产,平台由 Rubin GPU、Vera CPU、BlueField-4 DPU、ConnectX-9 SuperNIC、Spectrum-X 以太网交换芯片、HBM4 内存与硅光子组件等七类核心芯片构成。据彭博社 7 月报道,OpenAI 计划在第三季度大规模采用 Vera Rubin,CoreWeave、谷歌云、微软 Azure、Meta、戴尔等公司均已在使用该系统;CoreWeave 实测新款 NVL72 整机柜 token 处理量达上一代产品的 10 倍,Vera CPU 运行 Python 代码的速度则较 AMD Turin 快 18 倍。在更贴近智能体负载的 SemiAnalysis AgentX 测试中,Vera Rubin NVL72 的预览成绩达到 GB300 NVL72 的 30 倍;CoreWeave 的 TCO 分析亦显示,在相近交互性目标下,Vera Rubin NVL72 每 MW(百万瓦)token 吞吐较上代提升一个数量级,意味着同等电力预算下可承接更多推理流量、摊薄单 token 成本。此外,云厂商 Nebius 也独立提交了 Vera Rubin NVL72 预览成绩并展现出优秀性能。
【图表:Vera Rubin NVL72相对GB300 NVL72吞吐领先幅度】
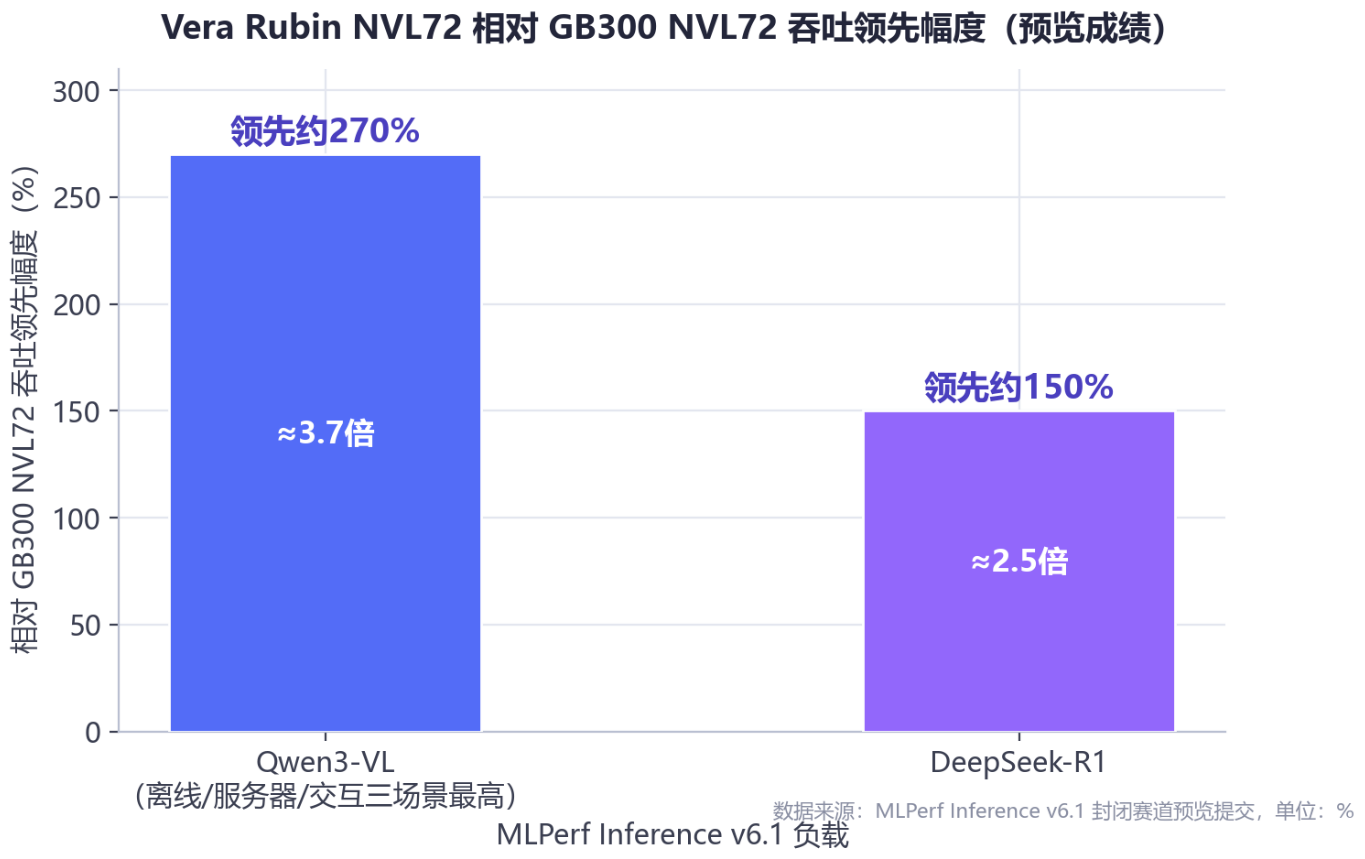
两项最重负载的预览成绩显示,Vera Rubin NVL72 相对现役 GB300 NVL72 的吞吐领先幅度在 Qwen3-VL 上最高约 270%(相当于 3.7 倍)、在 DeepSeek-R1 上约 150%(相当于 2.5 倍);且该成绩仍为预览状态,后续软件优化还有抬升空间,下一代平台推理性价比的跃升方向已经明确。
【图表:下一代Vera Rubin平台相对GB300 NVL72关键规格提升】
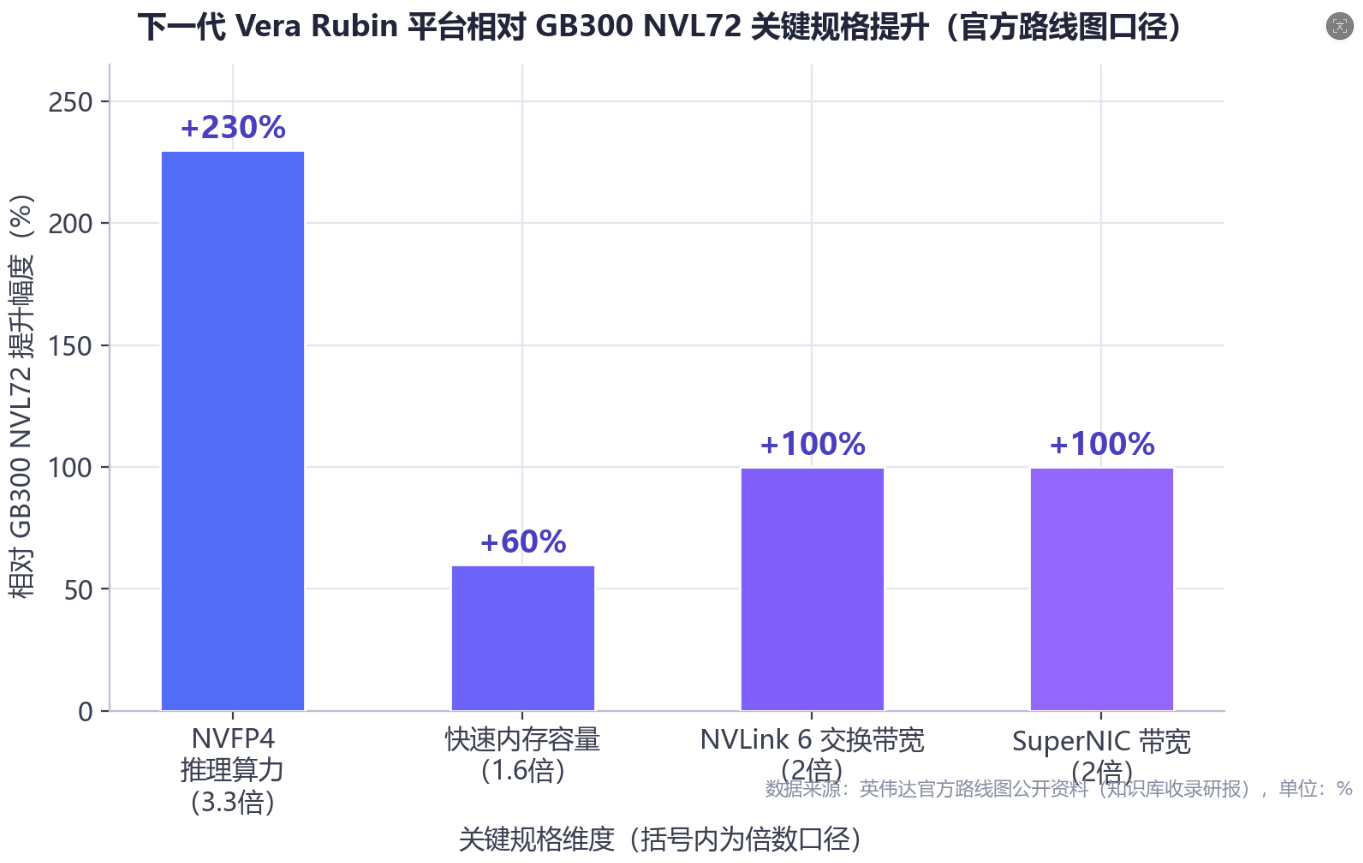
按官方路线图口径,下一代平台在 NVFP4 推理算力(3.3 倍,提升约 230%)、快速内存容量(1.6 倍,提升约 60%)、NVLink 6 交换带宽(提升 100%)与 SuperNIC 带宽(提升 100%)四个维度同步抬升,算力、内存与互联的协同升级是吞吐倍增的硬件基础。
三、GB300 NVL72:现役旗舰的规模化效率与持续软件增益
下一代亮相的同时,现役 Blackwell Ultra 平台 GB300 NVL72 展示了"上量不减效"的扩展能力:其 DeepSeek-R1 提交从单机架(72 卡)扩展到四机架(288 卡),在离线场景实现 99% 的扩展效率,吞吐随硬件增加近乎线性增长。英伟达强调,扩展效率取决于机架内高带宽低时延的 scale-up 互联、机架间网络与跨节点请求编排的协同,"更多 GPU"并不自动等于"成比例的更多吞吐"。在 WAN 2.2 文生视频基准上,GB300 NVL72 达到每秒 0.65 段 720p 视频、单段 5.7 秒,较单节点吞吐高 9 倍、时延低 7.5 倍。
软件侧的持续优化是 GB300 的另一护城河:v6.1 提交中,GB300 NVL72 在 Qwen3-VL 上的成绩较 v6.0 提升最高 1.6 倍(约 60%),来源包括更低的 KV 缓存精度、算子融合、更优内核以及基于 vLLM 与 Dynamo 的分离式服务;提交截止后的后续优化仍在 GPT-OSS-120B 与 DLRMv3 上带来进一步增益(尚未经 MLCommons 验证)。此前财报电话会上,英伟达还披露 GB300 相较六个月前吞吐提升 2.7 倍、单 token 成本下降 60%。
【图表:GB300 NVL72多机架扩展效率】
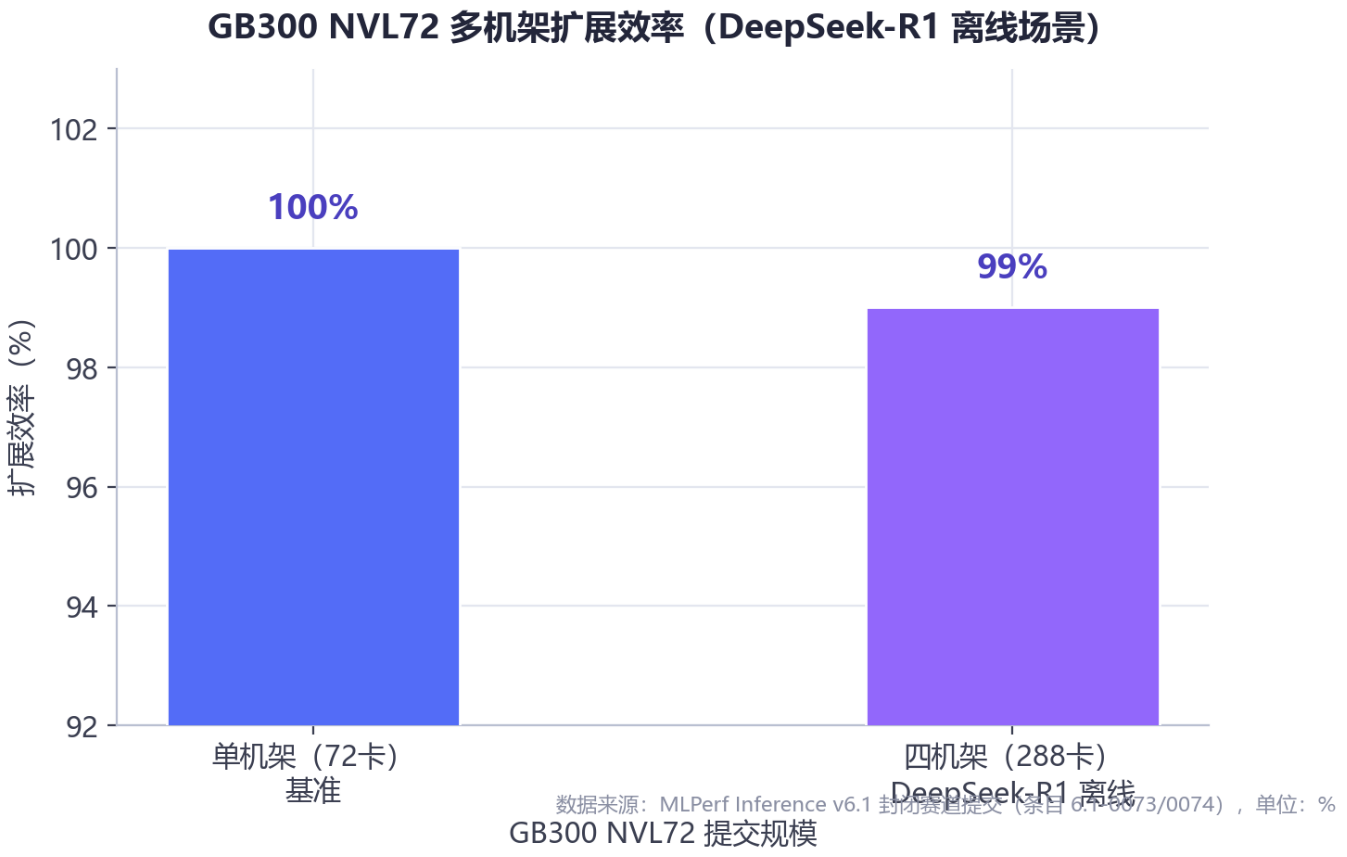
从 72 卡单机架到 288 卡四机架,吞吐几乎线性增长,以单机架为 100% 基准时四机架扩展效率仍达 99%,说明互联与软件栈没有在规模扩大时损耗算力;对以集群为单位采购的 AI 工厂而言,这直接决定单位算力的实际产出。
四、AMD 史上覆盖最广提交:模型家族从 3 个扩至 6 个,512 卡刷新吞吐纪录
AMD 本轮完成了其历史上覆盖面最广的一次提交:模型家族从上一轮 v6.0 的 3 个扩展到 6 个,覆盖语言、推理、文生视频与推荐负载,硬件横跨 Instinct MI355X、MI350X 与全新的 MI350P PCIe 卡,并有 7 家合作伙伴近乎复现了 AMD 的参考成绩。
同一代 MI355X 硬件靠软件迭代获得了可观增益:8 卡 GPT-OSS-120B 吞吐较上一轮提升 28%(离线)与 38%(服务器),Wan-2.2 SingleStream 提升 70%;72 卡 MI355X 在 v6.1 的 GPT-OSS-120B 吞吐超过上一轮 94 卡的成绩。在 8 卡节点上,MI355X 的 GPT-OSS-120B 成绩领先所选 NVIDIA B200 与 B300 提交,72 卡规模则领先 GB200;Wan-2.2 从上一轮的 Open 首秀升级为本轮领先的 Closed 成绩,离线与 SingleStream 分别较所选 NVIDIA B300 提交高 18% 与 11%。
规模化与纪录由云厂商 Crusoe 完成:AMD 将 GPT-OSS-120B 从 8 卡扩展至 72 卡(GPU 数量 9 倍),离线与服务器场景均保持 95% 的扩展效率;Crusoe 的 512 卡 MI355X 集群在 GPT-OSS-120B 上实现离线 575 万 token/秒、服务器 539 万 token/秒的聚合吞吐,为 MLPerf 历史最高纪录;DeepSeek-R1 上达到离线 290 万、服务器 241 万 token/秒,同样为该负载 MLPerf 历史最高。
两个"第一次"同样值得记录:MI350P PCIe 卡首轮提交 5 项 Closed 负载,成绩领先所选 NVIDIA RTX PRO 6000 Server Edition 与 H200 NVL,为既有双槽 PCIe 数据中心提供了不经 OAM 机架的升级路径;Dell 与 MangoBoost 提交了首个 32 卡异构推理结果——韩国 16 卡 MI300X 与美国 16 卡 MI355X 组成单一 GPT-OSS-120B 服务端点,实现离线约 28.5 万、服务器约 25.4 万 token/秒,正对应 MLCommons 所述横跨太平洋的地理分布式异构系统。硬件规格上,MI355X 配备 288GB HBM3E 显存与 8TB/s 带宽,MXFP4/MXFP6 峰值矩阵算力 10.1 PFLOPS;MI350P 为 144GB、4TB/s、4.6 PFLOPS。
gpt-oss-120b 之所以成为关键负载,与其身位有关:这是 OpenAI 于 2025 年 8 月开源的 1170 亿参数 MoE 模型(激活参数 51 亿),可在单张 80GB GPU 上运行,被视为开源推理生态的重要节点。AMD 面向下一代的 Helios 机架级平台与 MI455X(432GB HBM4、23.3TB/s 带宽)已于 7 月发布,AMD 同时预计 2026 年全球约 60% 的 AI 算力将用于推理,推理主战场定位进一步明确。此外,英特尔本轮也携 Arc Pro B70 与至强平台参与提交,竞争桌上的玩家仍在增加。
【图表:同代硬件软件优化增益对比】
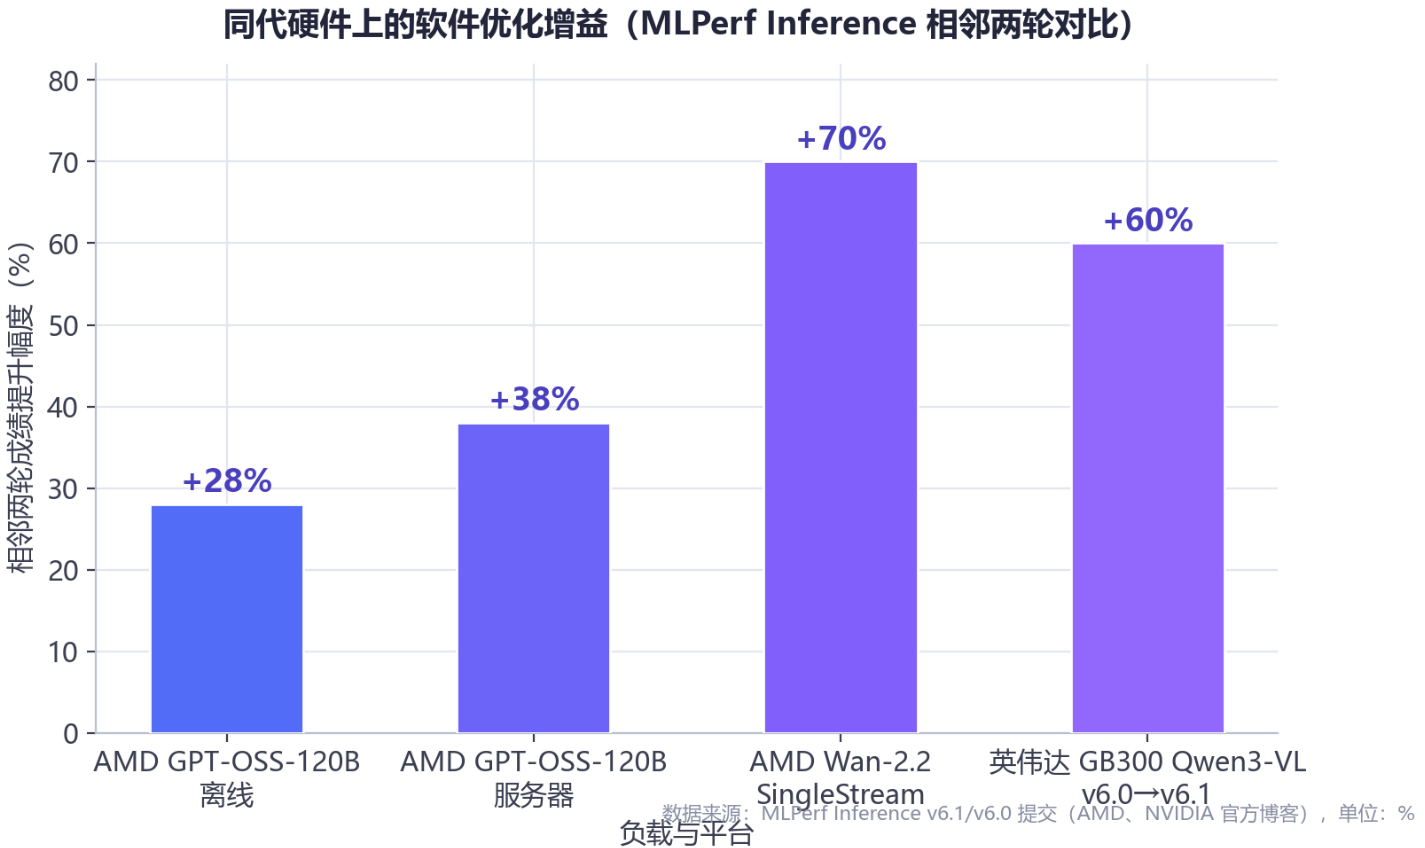
在同代硬件上,软件迭代持续释放增益:AMD 将 8 卡 GPT-OSS-120B 的离线与服务器吞吐分别提升 28% 与 38%,Wan-2.2 SingleStream 提升 70%;英伟达 GB300 NVL72 在 Qwen3-VL 上亦较上一轮提升最高约 60%(1.6 倍)。相邻两轮基准之间的追赶,很大一部分发生在软件栈——这也解释了为何预览状态的 Vera Rubin 成绩仍被官方明确标注"将持续优化"。(注:Crusoe 512 卡集群在 GPT-OSS-120B 上录得 MLPerf 史上最高的聚合 token 吞吐——离线 575 万、服务器 539 万 token/秒,DeepSeek-R1 上亦创下 290 万与 241 万 token/秒的历史纪录,因该口径为绝对吞吐值,本图未纳入。)
五、行业信号:推理基准走向"服务态",成本/性能曲线面临重估
纵观本轮结果,三条行业信号清晰可辨。
第一,基准形态正从"单机单卡"走向"集群级、服务态"。超过半数提交者采用 API 中心化框架,MLPerf Endpoints 将取代 Inference 成为数据中心场景的下一代基准,转向滚动提交与服务态测量;端到端 RAG 与边缘 Agentic 两项新测试,则把"多模型流水线"与"多轮智能体"这两类真实生产负载纳入度量。
第二,下一代推理硬件的性能曲线已经画出。Vera Rubin NVL72 以预览状态即录得对 GB300 NVL72 最高 3.7 倍的吞吐提升,叠加每 MW token 吞吐一个数量级的改善与单 token 成本降至 Blackwell 的 10% 的测算,Rubin 相对 Blackwell 有望显著改善推理的成本/性能曲线;而 GB300 在 288 卡规模上 99% 的扩展效率说明,现役平台在未来多个季度内仍是可靠的生产主力。
第三,竞争的天平并未静止。AMD 以 6 个模型家族、95% 扩展效率与 MLPerf 史上最高聚合 token 吞吐完成史上最广提交,用软件增益与规模纪录证明开放生态的追赶速度;Intel Arc Pro B70 等新硬件入场,加之 30 家参评机构与 6 家首次提交者,推理基准的竞争正在变成 AI 工厂全生命周期能效与成本的竞争。
对采购方而言,MLCommons 发布的可信数据恰恰回答了"AI 工厂经济学"的核心问题:同样的功率与资本开支下,谁能在服务态交付更多可用 token。随着 MLPerf Endpoints 时代的临近,这一度量口径将更加贴近真实账单。
结语
MLPerf Inference v6.1 以创纪录的 30 家参评机构、两项新测试与最高 5.7 倍的同比性能跃升,为本轮 AI 推理竞赛定格:英伟达 Vera Rubin NVL72 首秀即录得 GB300 NVL72 的 3.7 倍吞吐,预览了下一代推理平台的成本/性能弹性;GB300 NVL72 以 99% 扩展效率证明现役平台的规模化成色;AMD 则以史上最广提交与 512 卡吞吐纪录展示多元供给的成熟。基准走向服务态、负载走向智能体、竞争走向系统级——下一代 AI 工厂的选型逻辑,已经在这份成绩单中提前写明。